
学Agent的顺序,其实是反的
开篇
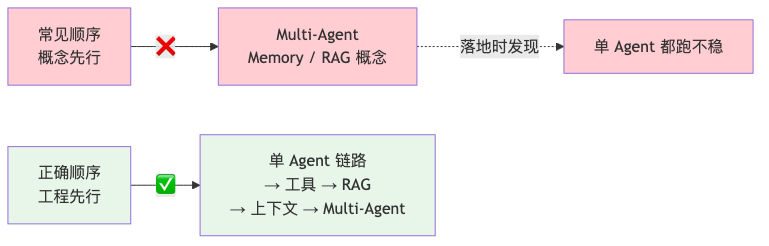
一个观察:很多人学 Agent,顺序是反的。
一上来就研究 Multi-Agent、Tree of Thought、Memory、Agentic RAG,架构图画了一张又一张,论文读了一篇又一篇。
真到自己动手——
连一个能稳定跑起来的单 Agent 都做不出来。
我见过聊 LangGraph 头头是道的人,问他「你的 Agent 怎么判断工具调用是成功还是失败」,愣住了。
不是能力问题,是顺序问题。
一、为什么都在追新概念
能理解。Agent 领域太卷了,Tree of Thought 还没搞懂,Graph of Thought 又来了。不追新,感觉要被淘汰。
而且这些概念听起来高级。Multi-Agent 听起来就能解决复杂问题。
但你追的这些东西,建立在什么上面?
建立在单 Agent 的稳定性上。
- Multi-Agent 的本质是多个单 Agent 协作。单 Agent 都不稳,乘起来更不稳
- Memory 的本质是上下文管理。推理链路都没跑通,加 Memory 只是加复杂度
地基不牢,越往上越危险。
二、正确的顺序
五个阶段,每个都有明确目标和过检标准。上一阶段不合格,不进下一个。
阶段一:单 Agent 推理链路跑通
" 目标是让 Agent 稳定完成"理解 → 推理 → 决策 → 输出"。
三个关键点:
Prompt 决定行为边界。 角色、任务、输出格式、约束、示例,五件套写全。别把 Prompt 当"随便写几句话"。
推理链路要可观测。 拆成步骤,出问题才知道坏在哪:
- 输出乱码 → 理解环节的问题
- 答非所问 → 推理环节的问题
- 格式不对 → 决策环节的问题
输出稳定性最容易被忽略,也最重要。 同样的输入,这次返 JSON 下次返纯文本,下游全崩。三个手段:
- 结构化输出强约束(
with_structured_output+ Pydantic schema) - Parser 兜底:解析失败走降级修复
- 多次采样 + 一致性检查,取多数结果
过检标准:同样输入输出基本一致、错误可追踪、格式可预期。
阶段二:工具调用
光会说话不够,得能做事。
工具定义三要素:描述清晰(什么时候用)、参数明确(怎么用)、返回可预期(结果怎么处理)。
真正的难点是工具执行失败怎么办。工具调用失败是常态不是异常:
async def safe_execute(tool_call, max_retries=3):
    for attempt in range(max_retries):
        try:
            return await execute(tool_call)
        except TransientError:
            await asyncio.sleep(2 ** attempt)   # 临时错误,退避重试
        except PermanentError:
            raise                                # 永久错误,直接失败
    return fallback_response()                   # 重试耗尽,降级
外加状态追踪,避免同一个工具反复调用。
过检标准:选对工具、失败有兜底、超时有重试。
阶段三:RAG
让 Agent 知道训练数据之外的事。
基本流程不复杂:问题 → 检索 → 上下文组装 → 生成。两个容易被低估的点:
- 引用溯源:每个观点能追溯到具体文档。不只是可信度问题,排查"Agent 为什么这么说"时全靠它
- 混合检索:纯向量检索对关键词、代码标识符经常失灵,向量 + 关键词加权混排,效果差距明显
过检标准:检索相关性达标、回答带引用、混排优于单路。
阶段四:上下文与状态
让 Agent 在长会话里"记住该记的"。
- 上下文边界:滑动窗口、摘要压缩、选择性保留,三选一或组合
- 状态管理:任务进度、决策历史、错误记录,要能 checkpoint 和 restore
- 结构化日志:每次推理、每次工具调用、每次决策都落日志。这是你唯一能依靠的调试手段
过检标准:上下文不无限增长、状态可追踪、日志完整、异常有降级。
阶段五:到这里,才配谈 Multi-Agent
Multi-Agent 的本质是多个可靠 Agent 之间的任务拆分和调度。
协作模式三种:流水线(A→B→C)、广播(一消息多 Agent)、树形(根 Agent 拆解分发再汇总)。
真正难的不是编排,是三个老问题:
- 通信协议:消息格式、上下文怎么带
- 状态同步:任务队列、结果队列、并发锁
- 冲突处理:两个 Agent 意见不合,置信度优先?投票?还是升级人工?
单 Agent 不稳就上 Multi-Agent,等于用分布式系统放大单点故障。
三、我的一个补充判断
这五阶段是骨架,实践里还有一个分水岭比阶段划分更重要:
你的 Agent 有没有"失败的记忆"。
很多人五个阶段都过了,Agent 还是做不稳,因为每次失败都靠现场猜。从阶段一起就记录:什么输入、什么决策、哪次工具调用、怎么失败的。积累两周,你对系统的理解会超过读十篇论文。
另外别迷信阶段严丝合缝。我在阶段二就提前用了简单的摘要压缩(本该是阶段四的事),因为工具结果把上下文撑爆了。阶段是检查点,不是围墙。
检验清单(收藏用)
- 阶段一:意图理解稳定 / 输出格式可预期 / 错误可追踪 / 输出一致
- 阶段二:工具选对 / 失败兜底 / 超时重试 / 结果正确解析
- 阶段三:检索相关性 / 上下文组装正确 / 引用溯源 / 混合检索
- 阶段四:上下文不膨胀 / 状态可追踪 / 日志完整 / 异常降级
- 阶段五:单 Agent 已稳 / 协议清晰 / 状态同步 / 冲突有解
记住
不是会多少框架,是有没有完整跑通过一次 Agent 工程。
单 Agent 链路 → 工具 → RAG → 上下文 → Multi-Agent。
所谓多 Agent 协同,说白了还是多个可靠 Agent 之间的任务拆分和调度。地基不牢,越往上越危险。