
你的 AGENTS.md 是个神经网络
前言:如何维护好 AGENTS.md
很多人发现维护 AGENTS.md / CLAUDE.md 很难。
常见的回答:"
- "我想什么就写什么"
- "让 Agent 自己写"
我也一样,很长一段时间都是凭感觉写。
直到我发现了一个更好的方法:
短版本:手写用户级的 AGENTS.md,把项目级的 AGENTS.md 当作神经网络来训练。
一、四种糟糕状态
看看任何超过几个月的项目记忆文件,通常是四种状态之一:
状态 1:空白
文件存在,但没内容。Agent 每次都要重新推导相同的东西。
状态 2:臃肿
Agent 每次做蠢事,就加一条规则。一年后 900 行,每行都要在每个 session 中付费。更糟的是,指令跟随被稀释,重要的规则被埋在无关规则下。
状态 3:过时
一半规则描述已被替换的构建系统。Agent 遵循过时指令,犯不必要的错误。
状态 4:漂移
AGENTS.md 说一套,CLAUDE.md 说另一套,不同的 harness 得到不同的指令集。
共同问题:文件基于轶事观察进行事务性编辑,添加比整合和修剪容易得多。
但可以告诉你该改什么的数据已经存在。每个 Agent session 都会在磁盘上留下一个 transcript。
二、两个文件,两种不同的工作
首先要理解的是,Agent 记忆文件可以写在两个级别,它们需要相反的处理方式。
用户级文件
我的全局 ~/.claude/CLAUDE.md 或 ~/AGENTS.md。
这是我的偏好和意见:
- 质量优先于开发成本
- 修复 bug 前先端到端重现
- 修复你路过的 flaky test,即使不是你的
这些是我拥有的偏好,很少改变。没有人应该编辑它们,没有工具应该"优化"它们,特别是 Agent。这个文件很小,是手写的。
项目级文件
实际上是个神经网络。
它被加载到在项目上运行的 Agent session 的系统提示中,它引导 Agent 的行为,这与在你使用的模型之上应用的微调 LoRA 没有什么不同。
不要像编辑文件那样编辑它,更好的做法是决定一个 token 预算,并像训练神经网络一样正确地训练它。
三、前向传播、反向传播
如果你从未训练过神经网络,整个循环是这样的:
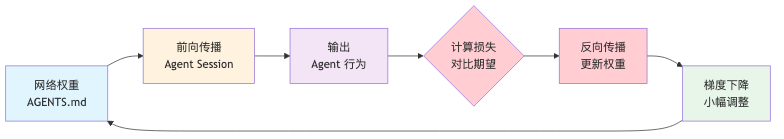
神经网络训练循环:
- 权重:网络有一堆权重,决定它的行为
- 前向传播:输入通过权重,得到输出
- 损失:输出与期望的差距
- 反向传播:从损失反向找出哪些权重负责
- 梯度下降:微调每个权重,减少差距
- 重复:许多小步,不是一次大改
两个细节很重要:
- 批量更新:不在单个样本上更新,因为单个样本可能是噪音
- 固定大小:网络有固定大小,更大的网络可以存储更多知识,但在推理时成本更高
四、映射关系
现在替换名词:
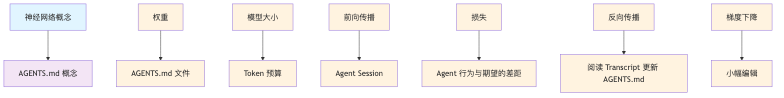
映射关系:
- AGENTS.md = 权重。决定 Agent 在这个 repo 中的行为,在读取一行代码之前。
- Token 预算 = 模型大小。更大的文件可以包含更多知识,产生更好的结果,但在推理时成本更高。
- Agent Session = 前向传播。Agent 加载文件,完成工作,文件不被触碰。
- 损失 = Agent 做的和你想要的之间的差距。它重新发现了 schema。它在 repo 使用 pnpm 时运行了 npm test。它违反了就在那里的规则。它遵循了结果是错误的规则。所有这些都在 transcript 中。
- 反向传播 = 阅读 transcripts 并更新 AGENTS.md 文件。找出哪些指令对损失负责,哪些指令 earned their keep,并在预算内进行小幅更新以减少损失。
它们惊人地相似。这样思考 AGENTS.md 也符合现实——大多数人实际上不会经常仔细阅读内容。它在实践中已经是一个黑箱。
缺失的是大多数人停在前向传播——他们在每个 Agent session 中使用 AGENTS.md 文件——他们缺乏的是基于损失优化权重的反向传播。
五、反向传播的实践
你可以手工做,我做了一段时间。这个实践有五个部分,每个部分都映射到训练循环中的某些东西。
1. 证据来自 Transcript,不是轶事
损失信号应该来自 Agent 的 session 日志,而不是你对上周二被恼火的回忆。将 AGENTS.md 文件的每个列表项或段落视为一个可寻址单元,对每个单元问:在哪些 session 中这很重要,它被遵循了吗,它被违反了吗,它是错的吗?还要问反过来的:Agent 做错了什么没有任何单元覆盖?
2. 批量后再更新
一个糟糕的 session 可能会因为随机原因发生。你不应该基于此重写权重。只有当你有一批数据时,你才能识别什么是真正的模式,什么只是噪音。这单个约束消除了大部分膨胀,因为大多数粘贴的规则是对从未再次发生的事件的反应。
3. 小步前进
每次传播一小把编辑,大概五次,每次是一个添加、删除、重写或提取到 skill。不是重写文件。对记忆文件的一大步与重新开始无法区分,你会丢失所有工作的东西。
4. 尊重预算,使用 Skills 作为释放阀
选择一个始终加载文件的预算,例如 5,000 tokens。在或接近它时,更新是零和的:每次添加都要命名删除或提取来支付。释放阀是 skills。广泛的指令(在约 20% 或更多的 session 中重要,或安全关键)留在记忆文件中。带有可检测触发器的窄指令变成 skill。带有不可检测触发器的窄指令是删除候选者。
5. 人工审查
最后一步,人工审查每个编辑,接受或拒绝。
六、自动化反向传播工具
所以我构建了 backpass 来轻松地以可重复的方式运行这个循环。
你可以通过在最近工作的 repo 中运行 npx -y backpass 来使用它。
它的形状就是上面的方法变成的流水线。一次运行是一个梯度步。
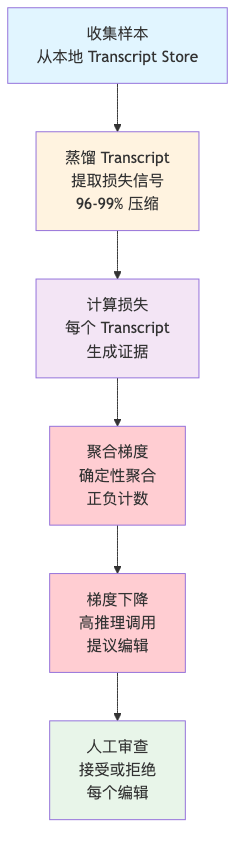
工作流程:
- 收集样本:直接从磁盘收集常见 agent harness 的本地 transcript stores,通过 cwd 或 git remote 将每个 session 绑定到 repo。
- 蒸馏 Transcript:将每个 transcript 蒸馏到携带损失信号的内容(被要求什么,Agent 说了什么,每个工具调用的单行形状),这是 96-99% 的减少,不涉及模型。
- 计算损失:每个 transcript 一个便宜的模型调用,生成对每个可寻址单元的证据,任何没有逐字引用的内容在代码中被丢弃,而不是在 prompt 中。
- 聚合梯度:确定性聚合:每单元正负计数、相关性份额、跨 session 的近似重复间隙聚类,以及在少于两个 session 中看到的任何间隙被丢弃。
- 梯度下降:一个高推理调用,提议编辑,门控机械运行:最多五次编辑,新规则两次 session,每次编辑一个引用,编辑后文件适合预算。违规恰好得到一个重新提示命名违规;第二个失败响亮地什么都不写。Token 增量从实际文本测量,因为模型报告的数字永远不可信。
- 人工审查:backpass apply 使用 lavish-axiom 呈现提议编辑列表,每个都有 diff 和证据,接受或拒绝每个,拒绝被记住,所以相同的编辑不会在没有新证据的情况下回来。
标志是它们真实名称下的训练旋钮:
--budget= 模型大小--max-edits= 学习率--min-gap-evidence= 批量大小--since= 训练窗口
节奏:每个活跃 repo 每周运行一次,阅读提议,拒绝模型过度达到的,接受其余的。随着时间的推移,AGENTS.md 变得越来越高效和有效。
七、为什么这是正确的形状
任何人一年前都可以让 Agent "清理这个文件"。这里真正重要的是科学严谨性:
- 真实 transcripts 作为唯一输入
- 逐字引用作为唯一可接受的证据
- 固定预算
- 小步长
- 最小批量
- 人工门控写入
八、总结
在 AGENTS.md 的维护中:
- 项目级 AGENTS.md 是个神经网络
- 像训练神经网络一样训练它
- 前向传播 = Agent Session
- 反向传播 = 阅读 Transcript 更新 AGENTS.md
- 批量更新 + 小步前进 + 人工审查
记住
你的 AGENTS.md 是个神经网络。
手写用户级的 AGENTS.md,把项目级的 AGENTS.md 当作神经网络来训练。
真实 transcripts + 逐字引用 + 固定预算 + 小步前进 + 人工审查。
附:backpass 工具
安装:
npx -y backpass使用:
# 在你的 repo 中运行
npx -y backpass

# 查看选项
npx -y backpass --helpGitHub:https://github.com/kunchenguid/backpass License:MIT