
Book-to-Skill:把技术书变成 AI 随身顾问
前言:当技术书变成 AI Skill
想象这样一个场景:
你买了一本很好的技术书,读了一遍。三个月后,你甚至不记得第 7 章的存在。
传统的解决方案都不够好:"
- 📄 "搜索 PDF" → 你得到的是页面列表,不是答案
- 🧠 "问 AI 关于这本书" → 它要么产生幻觉,要么说没有内容
- 📝 "边读边记笔记" → 你最终得到一个 200 行的文档,再也不会打开
如果这本书能变成 AI Skill 呢?
Book-to-Skill 正是这样的工具:将任何技术书籍、文档文件夹或来源集合转换为统一的 agent skill,准备好学习、参考并在工作时使用。
今天,我们就来分析这个革命性的开源项目。
一、项目概览
1.1 是什么?
Book-to-Skill 是一个将技术书籍转换为 AI Skill 的工具。
核心命令:/book-to-skill
核心特点:
- ✅ 多格式支持:PDF、EPUB、DOCX、TXT、Markdown、reStructuredText、AsciiDoc、HTML、RTF、MOBI/AZW/AZW3
- ✅ 结构化输出:生成 SKILL.md、chapters、glossary、patterns、cheatsheet
- ✅ 按需加载:章节文件按需加载,不占用 skill 预算
- ✅ 24–51× 节省 token:比将整本书倒入上下文节省 24–51× token
- ✅ 无幻觉:基于实际内容回答,不产生幻觉
- ✅ 跨平台支持:GitHub Copilot CLI、Amp、Claude Code
项目地址:https://github.com/virgiliojr94/book-to-skill 开源协议:MIT License
1.2 核心价值
传统技术书阅读的痛点:
- 读一遍就忘
- 搜索 PDF 得到页面列表,不是答案
- AI 要么产生幻觉,要么说没有内容
- 笔记文档再也不会打开
Book-to-Skill 的解决方案:
- 将书籍转换为结构化 skill
- AI 按需加载相关章节
- 基于实际内容回答,无幻觉
- 书籍成为工作流的一部分
二、核心功能
2.1 /book-to-skill 命令
基本用法:
/book-to-skill <path-to-document-folder-or-glob>... [skill-name-slug]支持的格式:
- 文档:PDF、EPUB、DOCX、TXT、Markdown、reStructuredText、AsciiDoc、HTML、RTF
- 电子书:MOBI、AZW、AZW3
- 输入:文件、文件夹、glob 模式、文件列表
示例:
# 处理单个文件
/book-to-skill ~/books/designing-data-intensive-apps.pdf

# 处理多个文件为一个统一 skill
/book-to-skill ~/papers/paper1.pdf ~/notes/export.txt unified-research

# 处理文件夹中所有支持的文件
/book-to-skill ~/workspace/project-docs/ project-knowledge

# 处理匹配 glob 模式的文件
/book-to-skill "~/books/*.epub" my-library

# 更新/折叠新内容到现有 skill 文件夹
/book-to-skill ~/articles/new-paper.pdf ~/.claude/skills/project-knowledge
2.2 生成的文件结构
运行 /book-to-skill your-book.pdf 会在 agent 的 skills 目录中创建完整的 skill:
~/.claude/skills/<slug>/
├── SKILL.md           # 核心思维模型 + 章节索引(~4,000 tokens)
├── chapters/
│   ├── ch01-*.md      # 第 1 章(~1,000 tokens)
│   ├── ch02-*.md      # 第 2 章(~1,000 tokens)
│   └── ...
├── glossary.md        # 所有关键术语,按字母排序(~1,500 tokens)
├── patterns.md        # 所有技术、算法和设计模式(~2,000 tokens)
└── cheatsheet.md # 决策表和快速参考规则(~1,000 tokens)文件说明:
- SKILL.md:核心思维模型 + 章节索引,常驻内存
- chapters/:每章一个文件,按需加载,不占用预算
- glossary.md:关键术语字典,按字母排序,带章节引用
- patterns.md:技术、算法和设计模式的集合
- cheatsheet.md:决策表和快速参考规则
Token 节省:
- 章节文件按需加载,不占用 skill 预算
- 只有当你问及相关主题时才会加载
- 比将整本书倒入上下文节省 24–51× token
三、实际应用场景
3.1 技术书籍
场景: 你有一本技术书,比如《Designing Data-Intensive Applications》,想在工作时快速查阅。
使用 Book-to-Skill:
/book-to-skill ~/books/designing-data-intensive-apps.pdf使用方式:
/designing-data-intensive-apps                    # 加载核心思维模型
/designing-data-intensive-apps replication        # 查找并解释主题
/designing-data-intensive-apps ch05               # 深入第 5 章
/designing-data-intensive-apps "你有哪些章节?"结果:
- AI 加载相关章节
- 基于实际内容回答
- 无幻觉,无 digging through PDFs
- 书籍成为工作流的一部分
3.2 内部文档
场景: 你有一个 docs/ 文件夹,包含架构决策记录、运行手册、入职指南。
使用 Book-to-Skill:
/book-to-skill ~/workspace/project-docs/ project-knowledge结果:
- 整个 docs/ 文件夹折叠为一个 skill
- 编码时可以询问
- 无需手动搜索文档
3.3 品牌和设计系统
场景: 你有一个品牌手册,包含声音指南、语调文档、组件原则。
使用 Book-to-Skill:
/book-to-skill ~/brand/brand-guidelines.pdf brand-style结果:
- 团队可以查询 brand style
- 无需浏览 60 页 PDF
- 保持一致性
3.4 研究集群
场景: 你有一堆论文加上自己的笔记,想合并为一个统一的 skill。
使用 Book-to-Skill:
/book-to-skill ~/papers/paper1.pdf ~/notes/export.txt unified-research更新:
# 当有新材料时,更新/fold-in
/book-to-skill ~/articles/new-paper.pdf ~/.claude/skills/unified-research结果:
- 论文 + 笔记合并为一个统一 skill
- 随新材料更新
- 可搜索的知识库
3.5 规范和标准
场景: 你有 RFC、API 合同、合规文档,经常参考但从未记住。
使用 Book-to-Skill:
/book-to-skill ~/specs/ api-specs结果:
- 规范变成 skill
- 快速查阅
- 无需记忆
四、技术架构
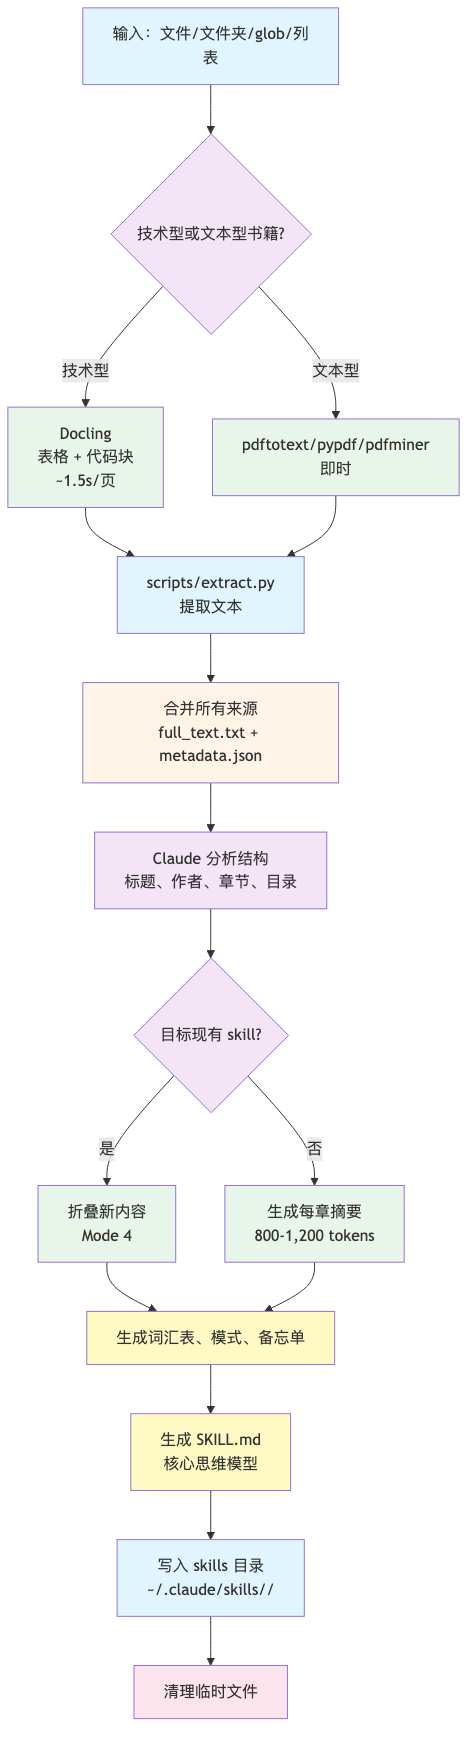
4.1 工作流程
4.2 核心组件
1. 提取器(scripts/extract.py)
- PDF:pdftotext(文本型)、Docling(技术型)
- EPUB:ebooklib + beautifulsoup4
- DOCX:python-docx
- HTML:beautifulsoup4
- RTF:striprtf
- MOBI/AZW/AZW3:Calibre ebook-convert
- TXT/Markdown/reStructuredText/AsciiDoc:内置
2. Claude 分析
- 分析结构:标题、作者、章节、目录
- 生成每章摘要(800-1,200 tokens)
- 技术型书籍包括代码示例和参考表
- 生成词汇表、模式、备忘单
- 生成 SKILL.md 和核心思维模型
3. Skill 写入
- GitHub Copilot CLI:
~/.copilot/skills/<slug>/ - Copilot CLI 或 Amp:
~/.agents/skills/<slug>/ - Claude Code:
~/.claude/skills/<slug>/
4.3 提取器对比
PDF 提取器:
| 书籍类型 | 工具 | 安装 | 速度 |
|---|---|---|---|
| 文本型(散文,少表格) | pdftotext (poppler) | sudo apt install poppler-utils | ⚡ 即时 |
| 文本型回退 | pypdf | pip3 install pypdf | ⚡ 即时 |
| 文本型回退 | pdfminer.six | pip3 install pdfminer.six | ⚡ 即时 |
| 技术型(代码、表格、公式) | docling | pip3 install docling | ~1.5s/页 |
提取基准(103 页技术书,仅 CPU):
| 方法 | 时间 | Tokens | 表格 | 代码块 |
|---|---|---|---|---|
| pdftotext | 0.1s | 27K | 0 | 0 |
| Docling | 164s | 27K (+1.2%) | 48 | 36 |
真实转换(测量:页数、提取的 tokens、自动检测的章节数、Claude Sonnet 4.5 上估计的一次通过成本):
| 书籍 | 格式 | 页数 | Tokens | 章节 | 成本 |
|---|---|---|---|---|---|
| Think Python 2 | 244 | 119K | 19 | $0.88 | |
| Working Backwards | 371 | 175K | 10 | $0.96 | |
| Pro Git | 501 | 229K | — † | $1.23 | |
| Moby-Dick | EPUB | — | 301K | — † | $1.42 |
† 章节自动检测需要显式的 Chapter N / Capítulo N 标题。Pro Git 使用节标题,Moby-Dick 使用章节标题/罗马数字,所以都不会自动分段——提取和转换仍然有效,但你手动指向节。一个完整的 skill 大约每本书花费 $1;远低于每会话重新阅读 PDF。
五、设计原则
5.1 核心原则
1. 密度优于完整性
- 1,000-token 摘要胜过 10,000-token 摘录
- 总是合成、总结、从源中提取信号
2. 实践者声音
- "Use X when Y",而不是"The book explains X"
- 直接可用的知识
3. 前置 SKILL.md
- 压缩保持前 ~5,000 tokens
- 最重要的内容在前
4. 按需章节
- 主题索引告诉 Claude 读取哪个文件
- 章节仅在需要时加载
5. 永不原始文本
- 总是合成、总结、从源中提取信号
- 不提供原始文本
5.2 Discovery Loop Tax
问题: PDF 阅读 agent 不仅阅读——它导航。问它一个问题,它获取目录,注意到一个无法定义的术语,拉取更多页面,回溯。这些跳转中的每一个都落在对话历史中,并在每个后续轮次中重新处理。为了保持在预算内,子代理然后被迫以残酷的比率压缩它读到的内容,向主代理传递一个降级的摘要,它无法根据源进行事实检查。
解决方案: Book-to-Skill 在编译时支付导航成本。在运行时,assistant 加载一个小的常驻核心 + 它需要的那个预编译章节——没有发现循环,没有压缩。
Token 节省: 24×–51× fewer tokens than dumping the book into context to answer one question。
六、安装与使用
6.1 安装
检查设置:
python3 scripts/extract.py --check打印每种格式安装了哪些提取器以及安装任何缺失内容的确切命令——不需要文件。
安装提取器:
PDF(文本型):
sudo apt install poppler-utils  # Linux
brew install poppler # macOSPDF(技术型):
pip3 install doclingEPUB:
pip3 install ebooklib beautifulsoup4DOCX:
pip3 install python-docxHTML:
pip3 install beautifulsoup4RTF:
pip3 install striprtfMOBI/AZW/AZW3:
- 从 https://calibre-ebook.com/download 安装 Calibre
6.2 使用
创建 skill:
/book-to-skill ~/books/your-book.pdf使用 skill:
/your-book-slug                    # 加载核心思维模型
/your-book-slug replication        # 查找并解释主题
/your-book-slug ch05               # 深入第 5 章
/your-book-slug "你有哪些章节?"
GitHub Copilot CLI: 你可能需要运行 /skills reload,以便新技能出现在 /skills 列表中。
Claude Code 和 Amp: 在下一个会话中自动获取。
七、优势与局限
7.1 优势
1. Token 节省
- 比 dumping the book into context 节省 24–51× token
- 章节按需加载,不占用预算
2. 结构化
- 不是摘要,是结构
- 核心思维模型 + 章节索引
- 词汇表、模式、备忘单
3. 无幻觉
- 基于实际内容回答
- 不产生幻觉
- 无 digging through PDFs
4. 多格式支持
- 支持 10+ 种格式
- 文件、文件夹、glob、列表
- 技术型和文本型书籍
5. 跨平台支持
- GitHub Copilot CLI
- Amp
- Claude Code
6. 开源免费
- MIT 协议
- 完全开源
- 可定制
7.2 局限
1. 处理时间
- Docling:~1.5s/页(技术型)
- 长书籍可能需要几分钟
2. Token 成本
- 转换需要调用 Claude
- 大约每本书 $1
- 远低于每会话重新阅读 PDF
3. 章节检测
- 需要显式的 Chapter N / Capítulo N 标题
- 某些书籍可能无法自动分段
4. 格式限制
- 某些格式需要外部工具
- MOBI/AZW/AZW3 需要 Calibre
八、最佳实践
8.1 选择合适的提取器
文本型书籍(散文,少表格):
- 使用 pdftotext
- 即时提取
- 适合小说、散文
技术型书籍(代码、表格、公式):
- 使用 Docling
- 保留 markdown 表格和代码块
- 适合技术书籍
8.2 使用按需加载
不要加载整本书:
❌ 差:把整本书倒入上下文
✅ 好:使用 /book-slug topic 按需加载好处:
- 节省 token
- 更快响应
- 更准确
8.3 更新现有 skill
当有新材料时:
/book-to-skill ~/articles/new-paper.pdf ~/.claude/skills/unified-research好处:
- 增量更新
- 保持最新
- 无需重新创建
8.4 组织 skill
按主题组织:
- 技术书籍:
~/.claude/skills/tech-books/ - 内部文档:
~/.claude/skills/docs/ - 研究论文:
~/.claude/skills/research/
好处:
- 易于管理
- 易于查找
- 易于更新
九、未来展望
9.1 短期未来
功能增强:
- 支持更多格式
- 优化提取速度
- 改进章节检测
性能优化:
- 加快 Docling 提取
- 降低 token 成本
- 提高准确性
9.2 中期未来
能力扩展:
- 支持音频转录
- 支持视频字幕
- 支持代码库
生态建设:
- 更多模板
- 更多预设
- 更多教程
9.3 长期未来
智能化:
- 自动选择提取器
- 自动优化章节检测
- 自动生成测试
标准化:
- 建立转换标准
- 建立最佳实践
- 建立社区
十、总结
10.1 核心回顾
Book-to-Skill:
- ✅ 将技术书转换为 AI Skill
- ✅ 支持多种格式
- ✅ 结构化输出
- ✅ 按需加载章节
- ✅ 24–51× 节省 token
- ✅ 无幻觉
- ✅ 跨平台支持
- ✅ 开源免费
核心价值:
- 让技术书成为 AI 随身顾问
- 不再遗忘,不再搜索 PDF
- 基于实际内容回答,无幻觉
- 书籍成为工作流的一部分
10.2 关键要点
"从读到用"
传统方式读一遍就忘,Book-to-Skill 让技术书成为 AI 随身顾问。
"从搜索到查询"
传统方式搜索 PDF 得到页面列表,Book-to-Skill 让你查询得到答案。
"从摘要到结构"
传统方式使用摘要,Book-to-Skill 生成结构(SKILL.md、chapters、glossary、patterns、cheatsheet)。
"Book-to-Skill 的本质"
"Book-to-Skill 不是要替代阅读,而是要让技术书成为 AI 随身顾问,帮助你更快地查找信息、应用知识、解决问题。"
核心价值:
- Token 节省:24–51×
- 结构化:不是摘要
- 无幻觉:基于实际内容
- 按需加载:章节按需加载
- 跨平台:支持多个平台
- 开源免费:MIT 协议
这就是 Book-to-Skill 的野心:让技术书变成 AI 随身顾问,让知识真正可用。
参考资源
- GitHub 项目:https://github.com/virgiliojr94/book-to-skill
- Agent Skills:https://github.com/agentskills/agentskills
- Docling:https://github.com/DS4SD/docling
- pdftotext:https://poppler.freedesktop.org/
- ebooklib:https://github.com/aik009/ebooklib
如果你觉得这篇文章有帮助,欢迎点赞、转发,让更多人了解这个把技术书变成 AI 随身顾问的强大工具!