
仓颉 Skill:读完一本书,带走的是能调用的 Skill,不是笔记
前言
你肯定有这种感觉:书看了不少,播客听了不少,B 站收藏了一堆长视频。 " 然后呢?什么都没变。知识停在"看过、听过、收藏过",真到做决策的时候,脑子里什么都调不出来。
最近火起来的另一个思路是"把人蒸馏成 skill"——nuwa-skill 做马斯克 skill、巴菲特 skill,人走了经验还在。
袋鼠帝(kangarooking)做的 cangjie-skill(仓颉 Skill) 走了另一条路:蒸馏人系统性表达过的内容。一本书、一期播客、一个两小时的长视频,里面沉淀的方法论,拆出来变成 AI Agent 能调用的 Skill 工具包。
一句话说清楚:
读完、看完、听完之后,带走一套能调用的方法论,而不是一篇会落灰的总结。
- GitHub:https://github.com/kangarooking/cangjie-skill
- 官网:https://cangjie-skill.com
- MIT 协议,支持 OpenClaw / Claude Code / DeepSeek Harness
一、项目身份
仓颉 Skill 是一个把高价值内容蒸馏成可执行 Agent Skills 的元 Skill。
它自己就是一份 SKILL.md 加一套方法论文档和提取器,没有服务端,跑在你的 Agent 里。
核心立场有三条,每条都和"AI 帮你读书"的常见做法对着干:
- 摘要不是复用。摘要、笔记、字幕整理都是压缩——压缩完你还是不知道"什么时候该用什么"。仓颉要的是结构化复用:可触发、可组合、可测试
- 不是所有内容都配变成 skill。真正值得做成工具的只是一小部分,所以流水线里有严格的淘汰门,宁缺毋滥
- 给人看的方法论不等于给 Agent 用的方法论。蒸馏必须面向执行,不面向消费
成果看得到:巴菲特致股东信 60+ 年 → 20 个投资判断 skill,《毛泽东选集》五卷 → 25 个方法 skill,《黄帝内经》→ 22 个,吴恩达《AI for Everyone》视频课程 → 25 个。连高数上册第一章都被蒸馏成了 8 个学习 skill。
二、主执行链路:RIA-TV++ 七阶段流水线
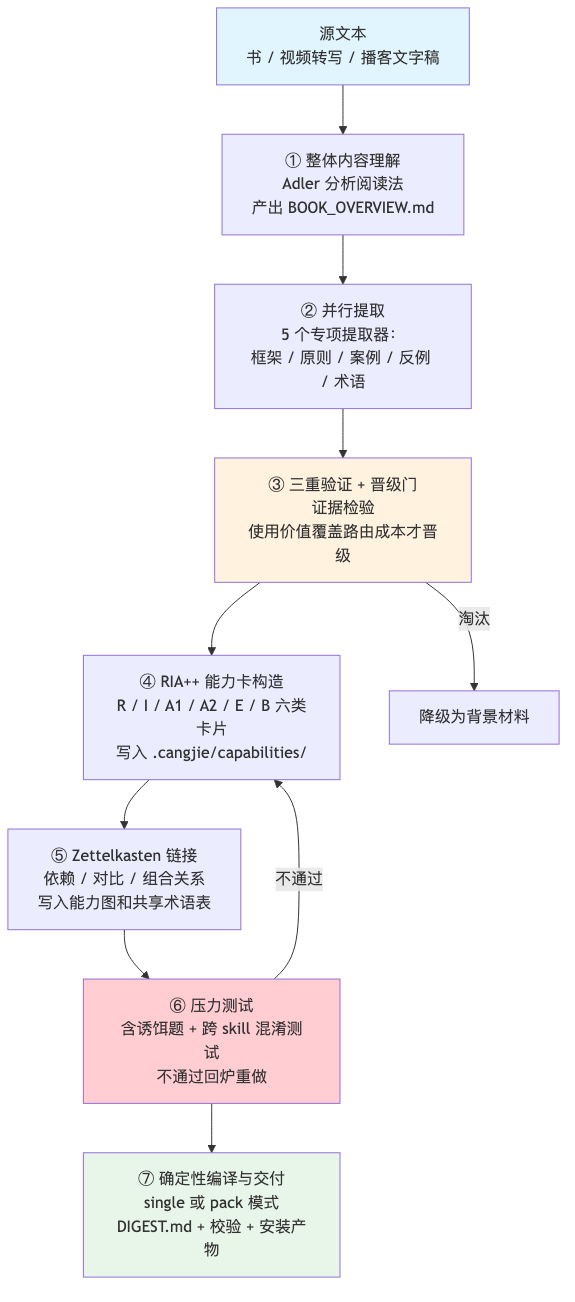
几个设计点值得展开:
第③步的晋级门是灵魂。候选方法论先过证据检验(原文有没有支撑),然后还要算一笔账:这个内容的使用价值,值不值得为它增加一个独立入口的路由成本?不值就降级为背景材料。这就是"宁缺毋滥"的执行机制。
第⑥步的诱饵题很聪明。给每个 skill 设计测试用例时故意放"诱饵"——问一些听起来相关但不该触发这个 skill 的问题,再看它会不会上钩。外加跨 skill 混淆测试:两个相近的 skill,Agent 能不能选对。测不过,整个回炉重建,不带侥幸。
第⑦步是确定性编译。同一份 Capability Bundle,可以编译成单路由入口(single),也可以编译成"路由 + 少量晋级独立 Skill"的紧凑包(pack)。输出可复现,不靠运气。
名字也有出处:RIA 来自赵周《这样读书就够了》的便签拆书法(Reading / Interpretation / Appropriation),TV 是 Triple Verification(三重验证),++ 是面向 Agent 的扩展——E(可执行步骤)+ B(边界)。拆书方法论 + 软件工程的质量门,杂交出来的东西。
三、核心模块与架构
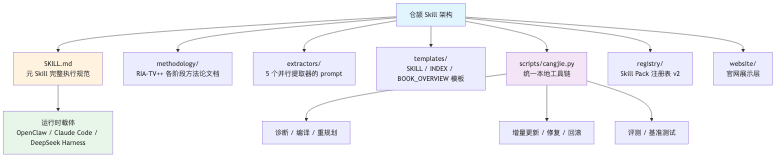
模块分工很清楚:SKILL.md 是大脑,定义整个蒸馏过程怎么执行;methodology 是教科书,每个阶段怎么做有独立文档;extractors 是五个工人,各自的 prompt 负责挖不同类型的方法论单元;cangjie.py 是车间主任,把诊断、编译、增量更新、修复、回滚、评测全收进一条命令。
v2.5.0 把 Capability Bundle 确立为唯一事实源:先产出稳定的能力卡和元数据,再编译安装产物。这个顺序很重要——下面讲状态流时会看到为什么。
四、数据与状态流
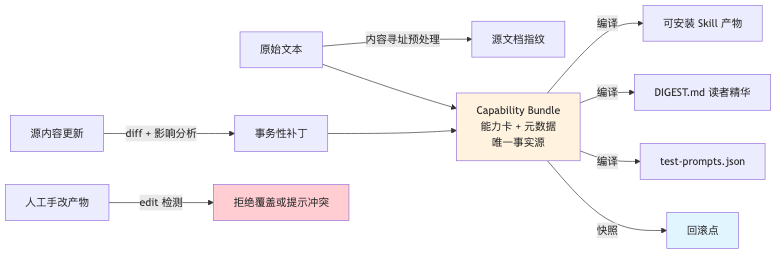
v2.5.0 的演进机制是这套系统最"工程"的部分:
- 源内容变了怎么办:内容寻址预处理 + 源 diff + 影响分析,只对受影响的能力卡打事务性补丁,不是全部重蒸
- 你手改了产物怎么办:手改检测会识别出来,拒绝盲目覆盖
- 改坏了怎么办:快照和回滚,一键回去
大多数"AI 帮你读书"的工具生成完就结束了,没有"维护"这个概念。仓颉把 skill 当持续演进的资产,不当一次性产物。这是它和玩具项目拉开差距的地方。
五、跨端边界
运行载体:主平台是 OpenClaw 和 Claude Code(SKILL.md 直接装),DeepSeek Harness 走独立安装包——下载 Release 的 tgz,SHA256 校验,dsh plugin add 本地装。适配层封装在安装包里,不污染主仓库。
展示与代码分离:官网负责 Skill Pack 的可视化浏览、教程和提交入口;GitHub 仓库是代码、方法论、模板的唯一来源。找东西去官网,用东西回仓库。
内容获取的边界:仓颉只吃文本。要蒸馏视频,官方建议先配 video-downloader skill——下载视频、抽字幕或音频转写,再把文本交给仓颉。分工明确,不越界抢活。
六、配置边界
作为元 Skill,它的配置面很克制:
- 输入边界:任何含"可抽取、可验证、可迁移"方法论的文本。书、访谈、演讲、课程、长文、资料集都行;纯叙事、纯娱乐内容会被晋级门自然淘汰
- 交付模式:
single(单路由入口)或pack(路由 + 晋级独立 Skill),按内容体量选 - 平台适配:OpenClaw / Claude Code 走 SKILL.md 直装,DeepSeek Harness 走 Release 包,不混装
没有 API key、没有服务端、没有数据库。文件进,skill 包出。
七、扩展点
这是这个项目最值得学的地方——它把自己设计成了生态的一个节点:
- 提取器可扩展:5 个提取器是独立 prompt 文件,想挖新类型的方法论单元(比如"决策框架"单独一类),加一个提取器就行
- 生态三件套咬合:nuwa-skill 蒸馏人,cangjie-skill 蒸馏书,darwin-skill 让 skill 进化。各管一段,互相引用而不是互相包含
- 外部来源可接入:book2startup、book2skill 等外部仓库经作者同意后挂进生态,Registry v2 向下兼容 v1 条目
- 社区产出真实存在:qbdx-hub 一个人就贡献了《孙子兵法》《周易》《我与地坛》《明朝那些事儿》6 个蒸馏仓库
八、风险点
说点冷水的。
1. 版权是悬着的剑。整本整本地蒸馏《黄帝内经》《毛选》问题不大,但蒸馏在版权保护期内的商业书籍再公开发布 skill 包,法律上站不站得住,项目方没有给出明确答案。个人自用没事,想商业化分发前想清楚。
2. 蒸馏质量依赖底座模型。七阶段流水线再严密,提取和验证还是 LLM 在做。方法论抽取跑偏、能力卡质量不稳定,工程流程只能兜底,不能根治。诱饵题测试能拦住大部分,但不是全部。
3. Skill 洪泛的隐忧。一本书 15-25 个 skill,你装 20 本书就是 400+ 个入口。路由成本上升、触发准确率下降,正是晋级门想防的问题,但防线在单本书内部,跨书的 skill 冲突没有治理机制。
4. "可调用"不等于"被调用"。蒸馏出一堆 skill 只是第一步,真实工作流里 Agent 会不会在恰当的时机想起它们,取决于你的使用方式。工具不会自动让你变好——这点和读书一样。
记住
知识停在"看过、听过、收藏过",是大多数人的常态。
仓颉 Skill 的答案:把方法论拆成可触发、可组合、可压力测试的 Agent Skill,让 AI 在真实决策里替你调用它。
拆书方法论(RIA)+ 软件工程质量门(三重验证、晋级门、确定性编译)——读书这件事,第一次被当成了工程来做。
参考资源
- GitHub:https://github.com/kangarooking/cangjie-skill
- 官网:https://cangjie-skill.com
- 生态:nuwa-skill(蒸馏人)/ darwin-skill(skill 进化)
- License:MIT