
上下文才是 AI 编程的核心:不是提示词写得多好,而是喂对了东西
前言
Cursor Learn 系列第二篇,讲一个多数人认知错位的点。
你以为提升 AI 输出质量靠写更好的提示词。有帮助,但不是关键。课程原话:与 AI 模型协作的本质在于管理你提供的上下文。
上下文管得好,平庸的提示词也能出好活;上下文喂错了,文采再好的提示词也救不回来。
一、这一课的身份
" 系列两课合一:《上下文》+《工具调用》。前者讲上下文是什么、为什么有限;后者讲模型怎么自己动手取上下文。合起来正好是"上下文工程"的完整拼图。
二、做菜比喻:输入决定输出
课程用煮汤类比 AI 协作:
- 食材=输入:代码库、文件、提示词
- 食谱=计划:人定的或模型建议的,拆成待办清单逐项勾
- 汤=输出:可应用的生成代码
不同厨师照同一食谱做出来的汤味道也略有差异——对,这就是上一篇讲的概率性。但核心逻辑不变:食材决定了汤的下限。
三、上下文的结构
上下文可以想象成一个长长的列表,是这段对话的工作记忆:
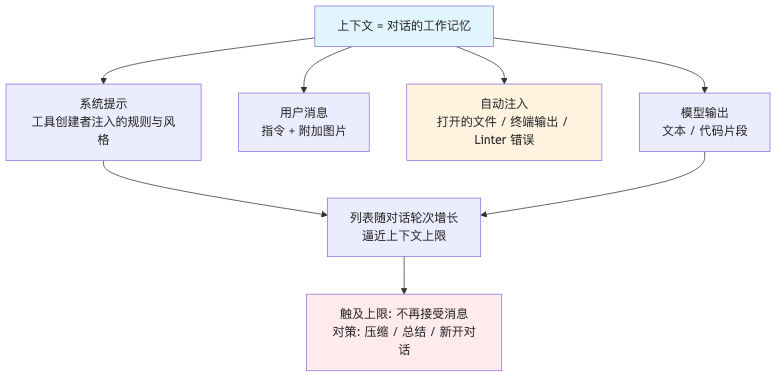
四个部分,两个容易忽略:
系统提示排在最前面,是工具创建者注入的规则和风格,引导模型输出的方向。你看不见它,但它每轮都在生效——理解这一点,就明白为什么同一个模型在不同工具里表现不同。
自动注入是 Cursor 这类工具的价值所在:当前打开的文件、终端输出、Linter 报错,都会根据代码库状态自动加进上下文。你不用手动贴,它们已经在场。
上下文会涨,且有上限。每条消息(输入和输出)都存进工作记忆,列表随轮次增长。每个模型的上下文限制不同,触顶后不再接受消息。就像和人聊天,三个小时前说过的话,你记不全,模型也一样。所以工具会提示剩余额度,或提供压缩总结。
管理对话长度本身是一项技能:该新开对话时新开,别恋战。
四、工具调用:让模型自己取上下文
前面讲的都是你主动喂上下文。如果想让它自己找呢?这就是工具调用。
课程比喻:你电话指导朋友做菜,看不到冰箱,只能凭记忆猜。朋友发来冰箱照片、报上烤箱实际温度,你的建议立刻靠谱——这就是工具调用给模型带来的能力:实时信息。
工作流程四步:
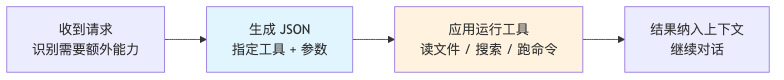
每个工具三要素:名称(read_file)、描述(何时用、怎么用)、参数(输入什么)。模型照着描述决定调不调、怎么调。
对编程来说,工具让模型能:读写代码库文件、搜索代码、跑 shell 命令、查文档搜网页、跑 linter 和测试。没有工具,它只能用你显式给的信息;有了工具,它能主动探索你的代码库。
五、工具不是免费的
工具调用从两头消耗 token:
- 工具定义占输入上下文,每个工具几百 token
- 工具结果进输出上下文,多少取决于返回内容
频繁用工具的对话,上下文涨得快、成本也高。但课程认为这个权衡通常值得——接入实时信息带来的收益更大。
还有个隐性成本:每次工具调用后,模型要重新评估截至当前的整个上下文,所以你会看到缓存输入 token 用量上涨。
六、MCP:工具的 USB 接口
内置工具之外,课程专门提了 MCP(模型上下文协议)。
类比很直接:USB 之于设备,MCP 之于 AI 工具。开发者构建一次工具,就能在许多不同的 AI 应用里运行——不用为每个产品重写一遍。
实际能连什么:Figma 拿设计文件、Linear 管理工单、数据库直接查询,还能自建 MCP 服务器接内部工具和 API。
这一层值得单独记住,因为它改变了游戏规则:模型的能力边界不再由厂商定义,而是由你接了什么工具定义。
七、风险点
- 上下文不是越多越好。塞满无关文件,噪声会稀释关键信息,模型照样被带偏。喂对东西比喂多东西重要
- 长对话会失忆。上下文逼近上限,早期约定被压缩或挤出,模型开始违反前面说好的事——这不是 Bug,是工作记忆的物理极限
- 工具描述即行为。描述写得含糊,模型调用时机就飘。工具质量的下限由描述质量决定
- token 成本不透明地累积。工具定义+结果+缓存重发,账单涨在你看不见的地方
记住
与 AI 协作的本质不是写更好的提示词,而是管理上下文。
上下文是对话的工作记忆:系统提示打底,你的消息和工具结果往上叠,随轮次增长,终有上限。
工具调用让模型自己取上下文,MCP 让工具构建一次处处运行——模型的能力边界,由你接的工具定义。
参考资源
- 课程:https://cursor.com/cn/learn/context 、https://cursor.com/cn/learn/tool-calling
- 系列下一篇:Agent 的原理与委派艺术