
顶级模型负责想,本地模型负责干:一套双模型协同开发系统的完整设计
前言
AI 辅助编程现在有个结构性矛盾。
顶级推理模型(比如 DeepSeek V4 Pro)规划能力强,但它是云端 API——你的生产数据、代码架构要发出去,有外泄风险,还有延迟和费用。本地部署的模型数据安全可控,但推理深度不够,复杂的任务规划做不好。
想的人够不着数据,数据里的人不会想。
一套双模型协同架构就是冲着这个矛盾来的。核心思路一句话:
让擅长思考的模型负责规划,让适合执行的模型负责落地,中间用 MCP 协议做标准化流转。
一、这个方案解决什么
三个层面的价值: " 安全与成本兼顾。规划阶段确实要调云端顶级模型,但生产数据经过脱敏才发;执行阶段的所有代码生成和文件操作完全在本地,敏感数据不出内网。云端只碰"想"的环节,不碰"做"的环节。
能力互补。大参数量模型干它擅长的:任务分解、架构设计、技术选型。本地 Flash 模型干它擅长的:低延迟、快速生成、快速迭代。谁也不越界。
用户门槛低。用户只做三件事:提需求、做决策、验收。代码细节完全不用管,系统自动走完从规划到上线的全流程。
二、可行性:两端各有硬支撑
规划端:DeepSeek V4 Pro
2026 年 8 月发布的正式版(DeepSeek-V4-Pro-0813),在 HLE、Terminal Bench、DeepSWE 这些 Agent 能力评测里超过 Claude Opus 4.8,部分榜单反超 Fable 5。
对"想"这个角色最要紧的几个特性:
- 1M 上下文——装得下完整的项目背景和调研资料
- 最大 384K Token 输出——装得下完整的方案
- 三档思考模式——按问题难度分配推理预算
- API 兼容 OpenAI 和 Anthropic 两种格式,Tool Calls、JSON Output 全支持——原来用别的 API 的,不用改代码就能切换
执行端:DeepSeek V4 Flash 本地部署
Flash(0731)专为编码和 Agent 工作流设计,同样 1M 上下文。本地部署有两条路:
方案 A,消费级硬件。模型原生是 FP8+FP4 混合量化,磁盘要 511GB,其中 Engram 记忆表就占 189GiB——全量跑需要 8 卡 H200 或 GB200 NVL4,谈不上消费级。真正的消费级路径是社区量化版(如 Unsloth Dynamic GGUF),在 RTX 4090/5090 这种 24GB 显存卡上跑蒸馏版。能跑,但要接受量化带来的质量损失。
方案 B,DGX Spark 双机。实测两台 DGX Spark 能跑满血 Flash,单流稳定 60-70 tok/s——日常编码够用了,达到实用标准。
推荐路径:验证期用 A(单卡量化版),生产切换 B(双机集群)。别一上来就买硬件。
工程底座:DeepSeek Harness
这是整个方案能落地的关键一环。DeepSeek 2026 年 8 月开源了 Agent 运行框架 DeepSeek Harness(DSH),核心理念是 "Agent = Model + Harness"——模型适配、工具能力、会话存储、沙箱权限全部插件化,全组件热插拔。
对双模型协同来说,DSH 提供了天然的底座:规划模型和执行模型就是两个不同的模型适配器插件,接进同一个 Harness 实例。
三、整体架构
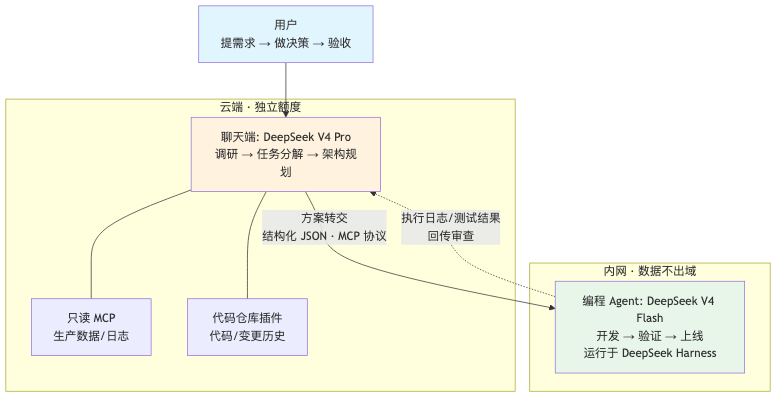
分工的本质是战略层与战术层分离:规划模型管"做什么、怎么拆、选什么技术",执行模型管"一行一行写出来、跑起来"。类似的分离架构已有先例——AARD 项目就是 Planning Model 与 Execution Model 分开的。
三个协同机制值得单独说:
方案转交要有格式。规划模型输出结构化 JSON:任务描述、技术栈选择、接口定义、文件结构、验收标准——通过 MCP 的 resources 能力暴露给执行端。不是把聊天记录甩过去。
要有反馈闭环。执行模型干完活,通过 MCP 把执行日志、测试结果回传给规划模型审查,规划模型据此调整后续规划。不闭环的系统,规划质量永远停在第一次 guess。
上下文分开管。规划端用 1M 窗口带完整背景;执行端靠 DSH 会话插件管代码上下文,吃前缀缓存的稳定性红利,多轮迭代不崩。
四、MCP 实现:两个 Server,三层防护
两个 MCP Server
只读生产数据 Server。给规划模型看生产数据/日志,安全控制五件套:API Key 每请求验证、SQL 沙箱化(只许 SELECT + 关键词黑名单)、参数化查询防注入、敏感字段脱敏(邮箱、身份证号)、审计日志。用官方 SDK 实现,别自己造协议。
代码仓库 Server。给规划模型看代码结构,方案制定前先理解现状。可以参考 repogate 的路子:封装 GitHub REST API,仓库检索、文件浏览、Issue/PR 查询、代码审查,做成 DSH 插件,零运行时依赖。
三层安全防护
MCP 本身的安全不能想当然。2026 年 5 月披露的 Ox-Security 漏洞就是前车之鉴:超过 20 万个 MCP stdio server 用 child_process.exec 直接执行用户输入,远程代码执行风险摆在那。
本系统的防护分三层:
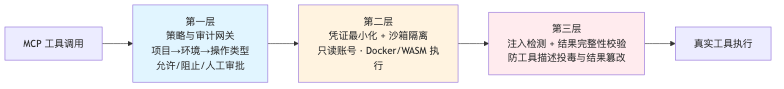
三层各堵一类洞:网关堵"不该调的调用",沙箱堵"执行环境逃逸",注入检测堵"工具本身被骗"。
与 DSH 的集成路径
DSH 的插件化让这步没有黑魔法:安装 DSH → 基于官方 MCP SDK 开发两个 Server 并打包成插件 → 在配置里注册插件 bundle → 模型适配器里分别配置云端规划模型和本地执行端点、设好转交触发条件 → 沙箱插件里配 Docker/WASM 执行环境和权限边界。规划模型和执行模型通过 Harness 统一调 MCP 工具,模型侧零额外适配。
五、实施路线图
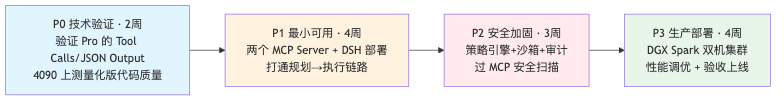
十三周走完四个阶段。节奏上最重要的设计是 P0 只花两周验证两件最不确定的事:云端模型的工具调用能力、量化模型的代码生成质量——这两件事不过关,后面全不用做。
六、四个风险,各有对策
规划模型的额度。Pro 调用不便宜。对策:独立额度控制 + 缓存机制——DSH 的前缀缓存让重复的规划请求命中缓存,调用量直接降下来。
本地量化模型的质量。消费级硬件上的量化版,复杂代码生成可能掉链子。对策:4090 起步、Spark 收尾的渐进路线,别跳步。
MCP 规范在动。2026 年 7 月的规范已经退役了协议握手和 Mcp-Session-Id。生态快速演进期,实现要保持向后兼容的弹性,别把协议版本焊死。
双模型格式一致性。规划输出和执行预期可能对不上。对策:转交层加格式校验和自动适配,再加一道人工确认兜底——全自动很性感,但规划到执行的接口是这个系统最脆弱的接缝。
记住
这套方案的骨架是三句话:想的模型不上数据,干的模型不出内网,中间流转走 MCP。
硬件路线别冒进:单卡量化版验证可行性,双机 Spark 上生产。安全别想当然:网关、沙箱、注入检测,三层一层都不能省。
最容易被忽略的一环是反馈闭环——执行结果回传给规划模型审查,规划质量才会随迭代上升。没有闭环,这只是一次性的"AI 出方案,人去执行"。
参考资源
- DeepSeek V4 Pro / Flash 官方发布说明
- DeepSeek Harness(DSH)开源仓库
- repogate:代码仓库 MCP Server 参考实现
- Ox-Security MCP 漏洞披露报告(2026-05)