
GPT-6 Astra 迁移建议:旧模型的 Skill 在拖后腿
前言
OpenAI 开发者博客发了一篇文章,标题很直白:Rethinking skills and prompts for GPT-6 Astra——为新模型重新审视你的 Skill 和 Prompt。
核心论点一句话:为旧模型写的指令,正在拖累新模型。 " 过去一年你为了"掰"住旧模型,在 skills、AGENTS.md、任务提示里堆了大量约束。模型越强,这些脚手架越多余——而 Astra 更进一步:这些约束不仅多余,还会帮倒忙。
- 原文:https://developers.openai.com/blog/rethinking-skills-and-prompts-for-gpt-6-astra
一、项目身份
- 谁写的:OpenAI 官方开发者博客
- 写给谁:用 Codex 等 coding agent 一年以上、攒了一大堆指令文件的开发者
- 讲什么:GPT-6 Astra 时代,skill 描述、AGENTS.md、决策边界、任务持久性四类配置怎么改
- 一句话定位:新模型不是更强 so 怎么都行,而是旧指南系统性失效,需要一次迁移审计
值得注意的姿态:官方明说"用新模型的机会清理你的房子,而且不用手动审——让 Astra 自己按本文标准跑一遍审计"。
二、主执行链路:一次指令迁移审计
文章虽是经验谈,但可以抽成一条清晰的迁移流程:
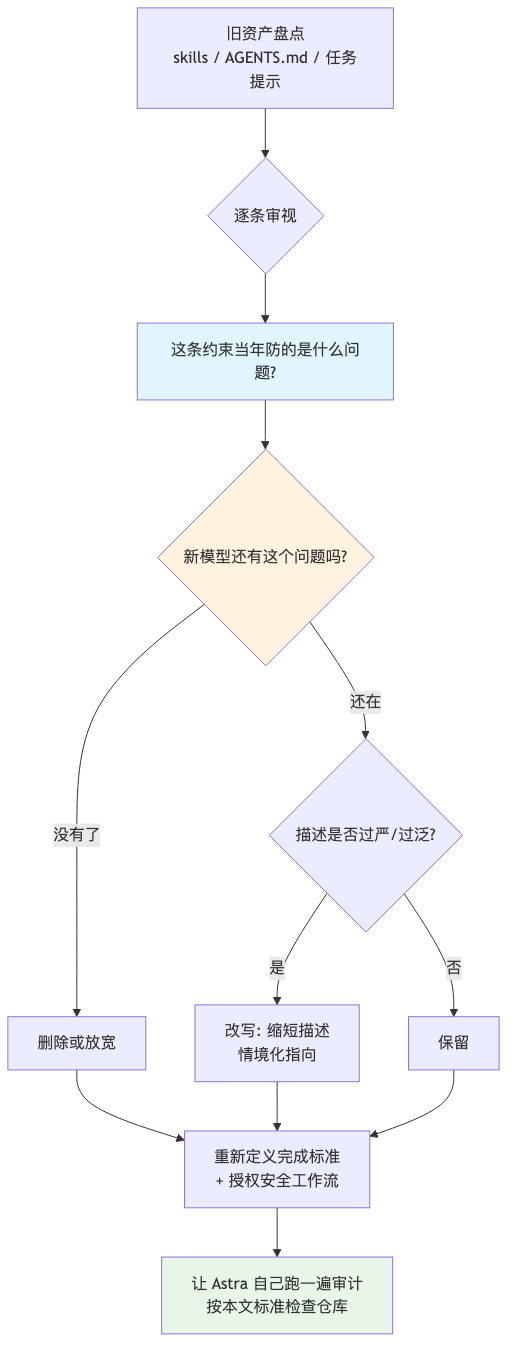
最后一步是这篇文章最实用的一招:迁移不用手工做,把文章里的标准喂给 Astra,让它审计你自己的指令文件。
三、核心模块:四个失效点与改法
模块一:Better Skills——描述膨胀与渐进披露
Skill 本质是"存成 Markdown 的 prompt,可打包资源和脚本"。当前生态的通病:人人往项目里塞一大堆 skill,然后两个连锁反应——
- 描述太长,skill 一多,Codex 开始自动缩短描述来塞进上下文,模型看到的更少,更难选对
- 描述互相矛盾、过度强调使用时机,模型加载一堆帮不上忙的指令
官方给 skill-creator 更新的三条准则:
① 描述尽量短,但时机要准。原例:坏描述是"创建和验证 Postgres schema 迁移。在涉及数据库、查询、模型或持久化时使用"——这会让模型一碰数据库就加载它。好描述是"在新增/修改迁移,或审查其上线时使用"。区别在于时机锁定到具体动作,而不是泛化到整个领域。
② 渐进披露(progressive disclosure)。读 skill 就烧上下文,逼近压缩边界还引入不相关指导。多工作流的 skill,根文档应该做成极简路由器:指向支撑文档和脚本,给足"去哪找"的线索,但不强迫读当下用不上的东西。
③ 少写食谱。旧模型需要手把手的详细步骤。新模型理解细微差别的能力强了,过度具体的指导现在会妨碍结果——以前是助力,现在是枷锁。
还有一个跨模型视角:仓库 skill 也在指导其他贡献者的 Agent,他们可能用不同模型。帮 Sol 或 Luna 的指导可能过度约束 Astra——写下指令时,想想哪些模型会读到它。
模块二:AGENTS.md——从"鼓励"到"授权"
AGENTS.md 在模型于你仓库工作的任何时候都生效,所以每条指令要经常重审:"它还需要吗?"
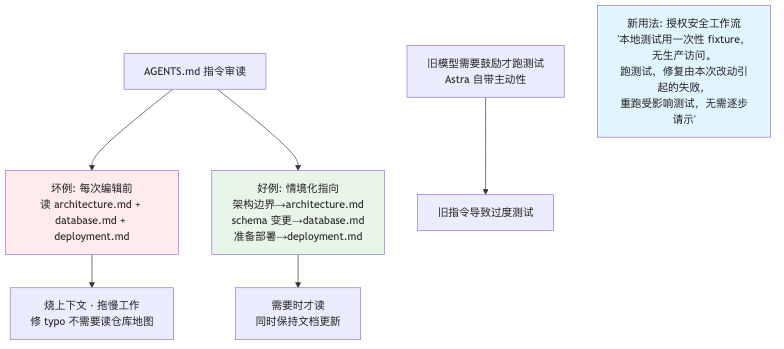
方向变了:旧时代写 AGENTS.md 是催促(记得跑测试啊),Astra 时代是授权(这些事你可以放手做,别来问我)。同一份文件,功能反转。
模块三:决策边界——你的严厉语气,它当真了
这是最反直觉的一条。如果旧模型曾经自作主张,你多半加过强硬措辞让它"先问再做"。这招对新模型有反作用:
Astra 是官方口中"最有对齐性的模型",不会在不确定安全时行动——你那些防旧模型的狠话,它可能太当真,在你其实希望它继续的地方停下来。
迁移动作:那些当年为了"防止跑太远"写的边界语言,现在要检查一遍——Astra 可能需要的是放宽,不是收紧。
模块四:持久性——先定义"完成"
旧模型(如 GPT-5.6 Sol)接到任务会一路猛冲很久。Astra 更谨慎:可能做完第一版实现就回来找你 review,活还没干完。
解法是开工前定义完成标准。如果任务包含"跑起来、看结果、修失败",就明说这是任务的一部分。提示词里写"第一版实现后停下来 review",会把模型拉向更早的停止点——先确认这个决策点你真的需要。想让它多探索,就说清楚探索什么、到哪停。
四、数据与状态流
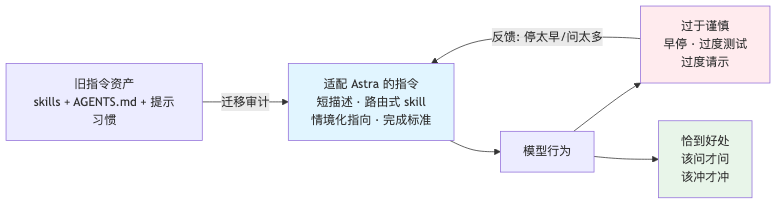
指令是输入,行为是输出,早期停止、过度请示、过度测试这些行为都是旧指令的回声。调优方向从"催它干活"变成"给它许可"。
五、跨端边界
- 适用范围:所有喂给模型的指令通道——skills、AGENTS.md、单次任务提示,三者同步审
- 跨模型边界:仓库级指令是公共设施。你的 AGENTS.md 会被其他贡献者的 Sol、Luna、Astra 同时读到——一刀切的措辞天然顾此失彼,按"最弱模型防跑飞、最强模型防早停"分层写
- 工具生态:以 Codex 为例,但原则对所有 agent harness 成立——模型换代,指令层要跟着换代
六、配置边界
文章划出的"该配"与"不该配":
| 该写 | 不该写 |
|---|---|
| 精确的使用时机(动作级) | 泛化的使用领域(数据库相关就用) |
| 根文档做路由器 | 根文档塞全部流程 |
| 情境化的文档指向 | 每次编辑前的强制阅读清单 |
| 授权安全工作流免请示 | 防旧模型闯祸的强硬禁令 |
| 开工前定义完成标准 | "第一版后停下 review"的惯性措辞 |
七、扩展点
- Astra 自审计:把文章标准喂给 Astra 审计你的指令文件,官方亲自背书的用法
- skill-creator 更新:新指引内置了这些失败模式的规避,新 skill 从源头按新标准写
- 分层指令策略:跨模型仓库可以演进出一套"按模型分层"的指令组织方式
- 提示词重写产业:旧 prompt 库的批量迁移本身可以交给 Agent 做——官方最后一句原话是"去造一个你以前不敢尝试的东西"
八、风险点
- 过度放权的反噬。文章教你放宽边界,但"授权安全工作流"的前提是你真确认它安全——本地测试无生产访问才免请示,判断责任在你
- 描述缩短的信息丢失。skill 太多时 Codex 自动截断描述,选错 skill 的根因可能是你的 skill 库该减肥,而不是模型不行
- 审计的循环依赖。让 Astra 审计为 Astra 写的指令,它可能保留对自己的偏爱——审计标准最好混入旧模型兼容性视角
- 迁移成本被低估。一年积累的指令文件,逐条重审"当年防什么、现在还需要吗",是个真活儿。团队仓库比个人仓库更费
- 文档腐化。情境化指向("schema 变更看 database.md")成立的前提是 database.md 是新的——文档不更新,指向就是误导
记住
模型换代,指令层要换代。为旧模型写的约束,对新模型是枷锁。
四个动作:skill 描述短而准、根文档做路由器;AGENTS.md 从催促变授权;决策边界按新模型判断力放宽;开工前定义完成标准防早停。
最省事的迁移方式官方已经给了:让 Astra 按这篇文章的标准,审计你自己的仓库。
参考资源
- 原文:https://developers.openai.com/blog/rethinking-skills-and-prompts-for-gpt-6-astra
- AGENTS.md 规范:https://agents.md