
Graph Engineering:让一群 AI 协作干活的工程化方法
"
前言:当 AI 遇上"协作"
想象这样一个场景:
你的团队决定使用多个 AI 来处理一个复杂任务。你尝试了各种方式:
- 让一个 AI 做完所有事 → 太慢,容易出错
- 让多个 AI 并行工作 → 不知道谁负责什么
- 让 AI 之间互相调用 → 很快就陷入混乱
问题出在哪里?
答案很简单:缺少协作的工程化方法。
这就是 Graph Engineering 要解决的问题。
今天,我们就来探讨这个让一群 AI 协作干活的工程化方法。
一、Graph Engineering 是什么?
1.1 核心定义
Graph Engineering 是一种通过流程图(Graph)的方式,将复杂任务拆解为多个节点(Node),并明确定义节点之间的关系(Edge),从而实现多个 AI 协作工作的工程化方法。
核心特点:
- ✅ 任务拆解:将复杂任务拆分为多个可管理的节点
- ✅ 关系定义:明确节点之间的依赖和数据流
- ✅ 可视化:用流程图直观展示协作关系
- ✅ 工程化:可执行、可监控、可优化
设计目标:
"让一群 AI 像团队一样协作,而不是像散沙一样各自为战。"
1.2 为什么是"图"(Graph)?
Graph 的定义:
- Graph = 节点(Node)+ 边(Edge)
- Node = 一个 AI 或一个任务
- Edge = 关系、依赖、数据流
为什么不是"列表"或"树"?
列表的问题:
Task 1 → Task 2 → Task 3 → Task 4- 只能线性执行
- 无法并行处理
- 无法表达复杂关系
树的问题:
        Task 1
       /      \
   Task 2    Task 3
   /    \    /    \
Task 4 Task 5 Task 6 Task 7- 只能表达层级关系
- 无法表达循环
- 无法表达跨层级依赖
图的优势:
Task 1 → Task 2 → Task 4
  ↓        ↓        ↑
Task 3 → Task 5 → Task 6
↖_______________↗- 可以表达任意关系
- 可以有循环
- 可以有跨节点依赖
- 可以并行执行
二、为什么需要 Graph Engineering?
2.1 单 AI 的局限性
场景:开发一个用户认证系统
单 AI 方式:
AI 1:我负责所有事情
  - 需求分析
  - 架构设计
  - 数据库设计
  - API 开发
  - 前端开发
  - 测试
  - 部署

问题:
  - 任务太多,容易遗漏
  - 上下文太长,容易混乱
  - 一个地方出错,全部重来
- 无法并行,效率低问题分析:
- ❌ 上下文过载:单个 AI 无法处理所有细节
- ❌ 错误传播:一个错误会影响整个任务
- ❌ 效率低下:无法并行处理
- ❌ 难以调试:不知道哪里出了问题
2.2 多 AI 的协作问题
场景:用多个 AI 开发用户认证系统
无协作方式:
AI 1:做需求分析
AI 2:做架构设计
AI 3:做数据库设计
AI 4:做 API 开发
AI 5:做前端开发
AI 6:做测试
AI 7:做部署

问题:
  - AI 2 不知道 AI 1 的输出
  - AI 4 不知道 AI 3 的数据库结构
  - AI 5 不知道 AI 4 的 API 接口
  - AI 6 不知道要测试什么
- AI 7 不知道部署什么问题分析:
- ❌ 依赖混乱:不知道谁依赖谁
- ❌ 数据丢失:输出无法传递
- ❌ 重复工作:多个 AI 做同样的事
- ❌ 难以监控:不知道整体进度
2.3 Graph Engineering 的解决方案
用 Graph Engineering 的方式:
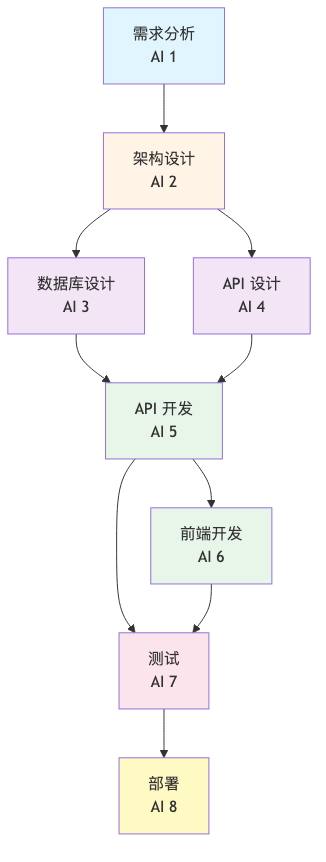
优势:
- ✅ 依赖清晰:一眼看出谁依赖谁
- ✅ 数据流动:输出自动传递给下一个节点
- ✅ 并行执行:数据库设计和 API 设计可以并行
- ✅ 易于监控:知道每个节点的状态
- ✅ 易于调试:知道哪个节点出了问题
三、Graph Engineering 的核心概念
3.1 节点(Node)
定义:
- Node = 一个 AI 或一个任务
- 每个 Node 有输入、处理、输出
Node 的类型:
1. 输入节点
Input Node:
  - 接收用户输入
  - 接收外部数据
  - 启动整个流程
2. 处理节点
Processing Node:
  - 执行具体任务
  - 调用 AI 模型
  - 生成输出
3. 输出节点
Output Node:
  - 返回最终结果
  - 保存到文件
  - 发送通知
4. 控制节点
Control Node:
  - 条件判断
  - 循环控制
  - 错误处理
3.2 边(Edge)
定义:
- Edge = 节点之间的关系
- 表示数据流动、依赖、控制流
Edge 的类型:
1. 数据边
Data Edge:
  - 传递数据
  - 节点 A 的输出 → 节点 B 的输入
2. 依赖边
Dependency Edge:
  - 表示执行顺序
  - 节点 B 必须等节点 A 完成
3. 控制边
Control Edge:
  - 条件分支
  - 如果条件成立 → 节点 A
  - 如果条件不成立 → 节点 B
3.3 流程图(Graph)
Graph 的结构:
1. 线性流程
A → B → C → D- 最简单的流程
- 顺序执行
- 适合简单任务
2. 并行流程
    B → D
A →
C → E- 并行执行
- 提高效率
- 适合独立任务
3. 条件流程
    A
   ↙ ↘
  B   C
   ↘ ↙
D- 条件分支
- 根据结果选择路径
- 适合复杂逻辑
4. 循环流程
    ↺
A → B → C- 循环执行
- 直到满足条件
- 适合迭代任务
四、实际应用场景
4.1 场景 1:内容创作流水线
任务:从研究到发布一篇技术文章
传统方式:
一个人做所有事:
  1. 研究主题
  2. 列大纲
  3. 写初稿
  4. 修改润色
  5. 配图
  6. SEO 优化
  7. 发布

问题:
  - 耗时长
  - 容易遗漏
  - 难以保证质量
Graph Engineering 方式:
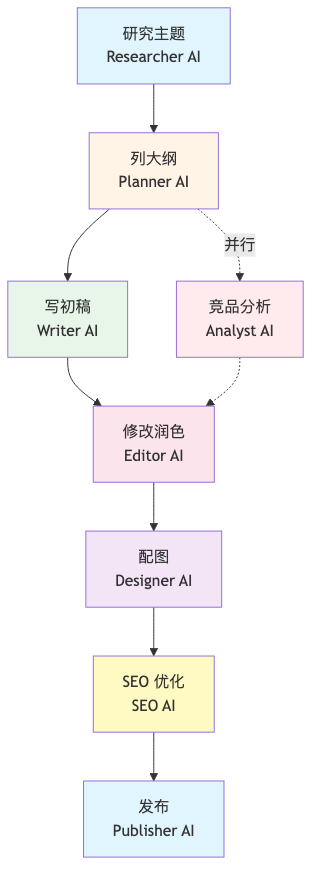
优势:
- ✅ 研究和竞品分析可以并行
- ✅ 每个 AI 专注自己的领域
- ✅ 输出自动传递
- ✅ 易于监控进度
执行流程:
1. Researcher AI 研究主题 → 输出研究笔记
2. Planner AI 列大纲 + Analyst AI 竞品分析(并行)
3. Writer AI 写初稿(基于大纲和研究笔记)
4. Editor AI 修改润色(基于初稿和竞品分析)
5. Designer AI 配图(基于润色后的文章)
6. SEO AI 优化(基于文章和图片)
7. Publisher AI 发布(基于优化后的文章)
4.2 场景 2:代码开发流水线
任务:从需求到部署一个功能
传统方式:
一个 AI 做所有事:
  1. 需求分析
  2. 架构设计
  3. 数据库设计
  4. API 开发
  5. 前端开发
  6. 测试
  7. 部署

问题:
  - 上下文太长
  - 容易出错
  - 难以保证质量
Graph Engineering 方式:
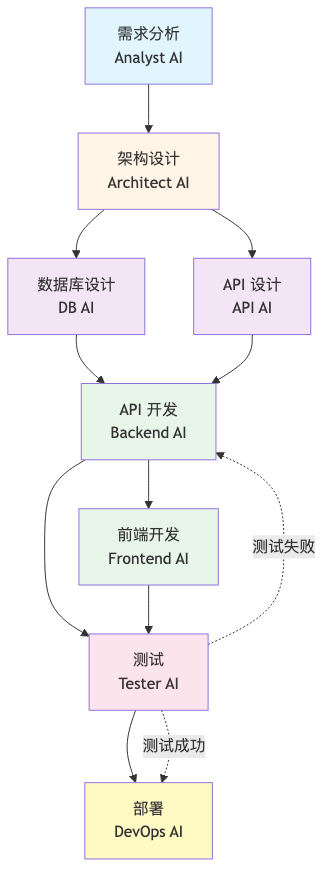
优势:
- ✅ 数据库设计和 API 设计可以并行
- ✅ 每个 AI 专注自己的领域
- ✅ 测试失败可以自动回滚
- ✅ 易于调试和监控
4.3 场景 3:客户服务流水线
任务:处理客户问题
Graph Engineering 方式:
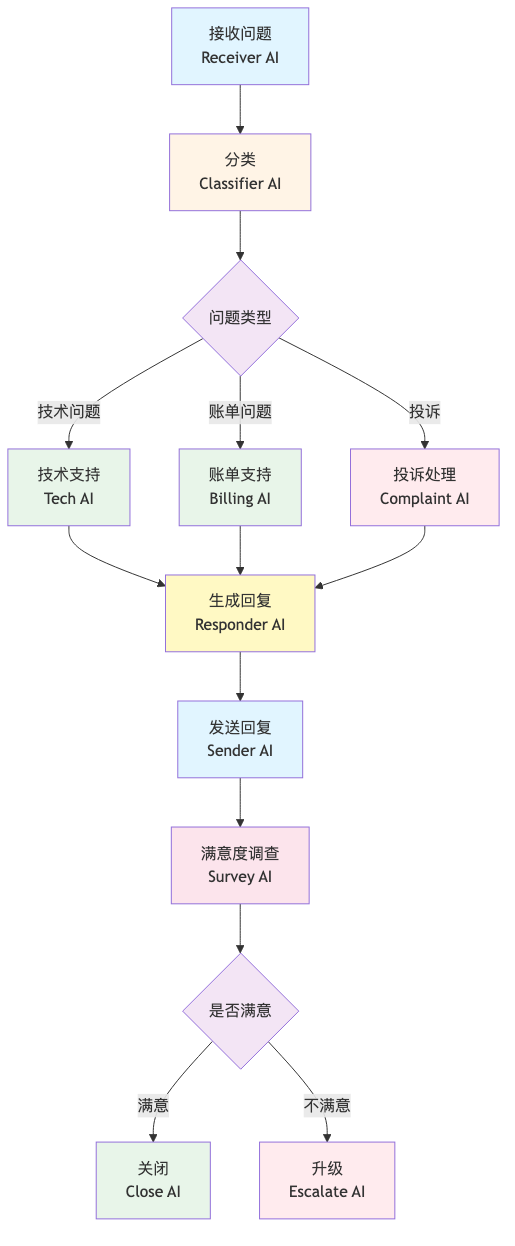
优势:
- ✅ 自动分类问题
- ✅ 不同问题分给不同 AI
- ✅ 满意度调查自动触发
- ✅ 不满意自动升级
五、技术实现
5.1 核心组件
1. Graph 定义
# 定义 Graph
name: content_creation_pipeline
nodes:
  - id: research
    type: processing
    ai: researcher
    inputs:
      - topic
    outputs:
      - research_notes

  - id: planning
    type: processing
    ai: planner
    inputs:
      - research_notes
    outputs:
      - outline

edges:
  - from: research
    to: planning
    type: data
2. 节点执行器
class NodeExecutor:
    def execute(self, node):
        # 获取输入
        inputs = self.get_inputs(node)

        # 调用 AI
        outputs = node.ai.execute(inputs)

        # 保存输出
        self.save_outputs(node, outputs)

        return outputs
3. 边路由器
class EdgeRouter:
    def route(self, outputs, edges):
        # 根据输出选择下一个节点
        for edge in edges:
            if self.match_condition(outputs, edge.condition):
                return edge.to_node
        return None
4. Graph 引擎
class GraphEngine:
    def execute(self, graph):
        # 初始化
        self.initialize(graph)

        # 执行
        while not self.is_complete():
            # 获取可执行的节点
            ready_nodes = self.get_ready_nodes()

            # 并行执行
            for node in ready_nodes:
                self.execute_node(node)

            # 路由到下一个节点
            self.route_outputs()

        # 返回结果
        return self.get_results()
5.2 关键技术
1. 并行执行
# 使用线程池或进程池
from concurrent.futures import ThreadPoolExecutor

def execute_parallel(nodes):
    with ThreadPoolExecutor(max_workers=4) as executor:
        futures = [executor.submit(execute_node, node)
                  for node in nodes]
        results = [f.result() for f in futures]
    return results
2. 状态管理
# 跟踪每个节点的状态
class NodeState:
    PENDING = "pending"
    RUNNING = "running"
    COMPLETED = "completed"
    FAILED = "failed"

# 状态存储
state_store = {
    "research": NodeState.COMPLETED,
    "planning": NodeState.RUNNING,
    "writing": NodeState.PENDING
}
3. 错误处理
# 重试机制
def execute_with_retry(node, max_retries=3):
    for i in range(max_retries):
        try:
            return execute_node(node)
        except Exception as e:
            if i == max_retries - 1:
                raise e
            time.sleep(2 ** i)  # 指数退避
4. 监控和日志
# 监控节点执行
def monitor_node(node):
    logger.info(f"Starting node: {node.id}")

    start_time = time.time()
    result = execute_node(node)
    end_time = time.time()

    logger.info(f"Completed node: {node.id}, "
                f"duration: {end_time - start_time}s")

    return result
六、Graph Engineering 的优势
6.1 效率提升
传统方式:
单 AI 顺序执行:
  任务 1: 10 分钟
  任务 2: 10 分钟
  任务 3: 10 分钟
  总计: 30 分钟
Graph Engineering:
多 AI 并行执行:
  任务 1: 10 分钟
  任务 2: 10 分钟(并行)
  任务 3: 10 分钟
  总计: 20 分钟

效率提升: 33%
6.2 质量提升
传统方式:
- 单 AI 容易遗漏细节
- 单 AI 容易产生错误
- 难以保证质量
Graph Engineering:
- 每个 AI 专注自己的领域
- 多个 AI 互相检查
- 易于保证质量
6.3 可维护性提升
传统方式:
- 代码混乱
- 难以修改
- 难以扩展
Graph Engineering:
- 结构清晰
- 易于修改
- 易于扩展
6.4 可观测性提升
传统方式:
- 不知道执行到哪
- 不知道哪里出错
- 难以调试
Graph Engineering:
- 清晰的执行流程
- 明确的错误位置
- 易于调试
七、挑战与局限
7.1 技术挑战
1. 复杂度管理
- 问题:节点太多,难以管理
- 解决:分层设计,子图
2. 数据传递
- 问题:节点间数据传递复杂
- 解决:标准化数据格式
3. 错误处理
- 问题:一个节点出错,影响全局
- 解决:重试机制,容错设计
7.2 设计挑战
1. 任务拆解
- 问题:如何合理拆分任务
- 解决:经验积累,最佳实践
2. 依赖管理
- 问题:如何管理复杂依赖
- 解决:依赖图,拓扑排序
3. 资源分配
- 问题:如何分配 AI 资源
- 解决:资源池,负载均衡
7.3 运维挑战
1. 监控
- 问题:如何监控整个流程
- 解决:日志,指标,追踪
2. 调试
- 问题:如何调试复杂流程
- 解决:可视化,断点,单步执行
3. 优化
- 问题:如何优化性能
- 解决:并行,缓存,异步
八、未来展望
8.1 短期未来(1-2 年)
工具成熟:
- 更多 Graph Engineering 工具
- 更好的可视化
- 更强的调试能力
标准建立:
- Graph 定义标准
- 节点接口标准
- 数据格式标准
8.2 中期未来(3-5 年)
自动化优化:
- 自动拆分任务
- 自动优化流程
- 自动资源分配
智能协作:
- AI 自动协商
- AI 自动分工
- AI 自动优化
8.3 长期未来(5-10 年)
自组织系统:
- AI 自动形成团队
- AI 自动分配任务
- AI 自动优化流程
大规模协作:
- 成百上千个 AI 协作
- 处理超复杂任务
- 达到人类团队水平
九、总结
9.1 核心回顾
Graph Engineering 的核心价值:
- ✅ 任务拆解:将复杂任务拆分为可管理的节点
- ✅ 关系定义:明确节点之间的依赖和数据流
- ✅ 可视化:用流程图直观展示协作关系
- ✅ 工程化:可执行、可监控、可优化
Graph Engineering 的核心概念:
- 节点(Node):一个 AI 或一个任务
- 边(Edge):关系、依赖、数据流
- 流程图(Graph):节点和边的组合
Graph Engineering 的应用场景:
- 内容创作流水线
- 代码开发流水线
- 客户服务流水线
9.2 关键要点
Graph Engineering 不是:
- ❌ 不是简单的流程图
- ❌ 不是固定的模板
- ❌ 不是一次性的
Graph Engineering 是:
- ✅ 是工程化的协作方法
- ✅ 是可执行的定义
- ✅ 是持续优化的过程
9.3 最终思考
Graph Engineering 的本质:
"Graph Engineering 不是要创造新的 AI,而是要让一群 AI 像团队一样协作。"
核心价值:
- 让 AI 协作更高效
- 让 AI 协作更可控
- 让 AI 协作更可观测
这就是 Graph Engineering 的野心:让一群 AI 协作干活。
参考资源
- Graph Theory:https://en.wikipedia.org/wiki/Graph_theory
如果你觉得这篇文章有帮助,欢迎点赞、转发,让更多人了解这个让一群 AI 协作干活的工程化方法!