
halogen-flash:手写 kernel 快 4 倍,但不许搬家
前言
推理引擎这几年的主流叙事是通用性:一个 vLLM/llama.cpp 跑所有模型、所有硬件,哪里都能搬。
halogen-flash 反着来。它是 Qwen3.8-Flash-Next 这个模型在 AMD Strix Halo(gfx1151)这块芯片上的专用推理引擎——每个 kernel 只为这一块 GPU 和这一个模型家族手写,没有通用运行时、没有可移植层、没有 fallback 路径。
代价写在脸上:只跑在这一块硅片上,权重格式连 llama.cpp 都打不开。收益也写在脸上:32K 长上下文问答,端到端比这块硬件上最快的公开成绩还快约 4 倍——而且靠的不是把精度压得更狠。
这个项目由两部分组成:GitHub 上的 halogen-flash-server(引擎,闭源,容器分发),HuggingFace 上的 halogen-qwen3.8-flash-next(专用格式权重)。这篇把它们当一个整体拆开讲。
一、项目身份
halogen-flash-server + halogen-qwen3.8-flash-next 是一套绑定 AMD Strix Halo 的 Qwen3.8-Flash-Next 专用推理方案。
一句话说清楚:
为一块 GPU、一个模型家族手写全部 kernel 的推理引擎,配上自研量化格式的权重,32K prefill 快到 23 秒,通用引擎在同一块芯片上要 100 秒以上
- 引擎:github.com/peonist-ai/halogen-flash-server(闭源,ghcr.io 容器分发,当前 0.13.8)
- 权重:huggingface.co/peonist-ai/halogen-qwen3.8-flash-next(.hgn 自研格式,Apache-2.0,量化值全部由官方从 BF16 原件自产,未导入第三方量化)
- 硬件前提:AMD Strix Halo(gfx1151),128GB 统一内存——没得选,这是设计不是缺陷
应用方向:把这块消费级芯片变成一个能跑 179.55B 参数 MoE 模型、支持 1M 上下文(opt-in)、兼容 OpenAI API 和 Codex Responses API 的本地推理盒子。 "
二、核心思路:三个"不做妥协"
1. 量化是前提,不是优化
Qwen3.8-Flash-Next 是 125B 参数 + 51B n-gram 嵌入表,BF16 要 335GB,FP8 也要 173GB——Strix Halo 的 128GB 统一内存里,不量化根本装不下。所以问题从来不是"要不要量化",而是"比特花在哪"。
答案是 5.53 bpw(全参数口径),比三个竞品里最快的 5.51 bpw 还略高——它不是靠砍精度换速度。钱花在刀刃上的细节下一节讲。
2. 质量 loss 集中的地方,用极小的补丁修
这是权重仓库最聪明的部分:质量侧车(sidecar)。
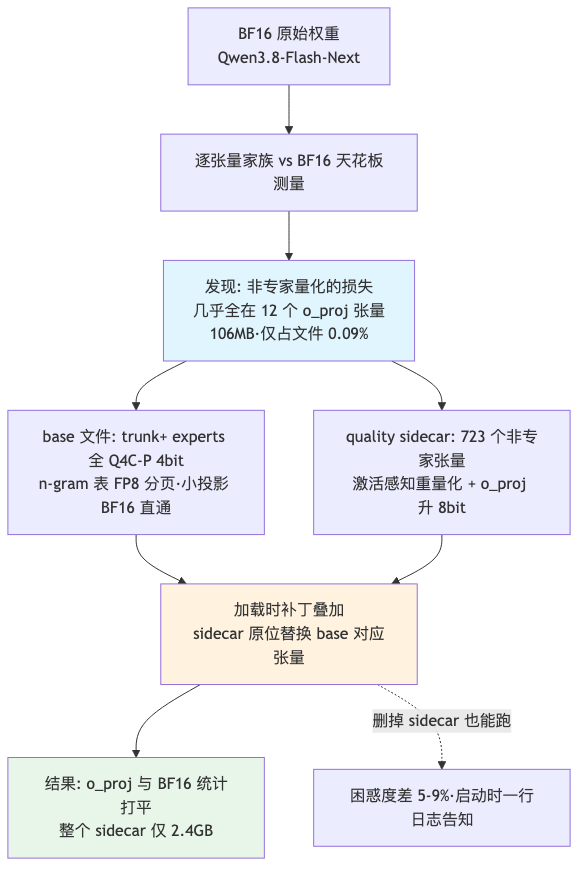
机制是校准发现:4-bit trunk 会过度自信,而损失集中在最难的四分位预测上——那些预测恰好走那 12 个 o_proj。把 0.09% 的文件升到 8bit,测量结果就是与 BF16 统计打平。质量损失在哪,就把比特花在哪,而不是全模型均匀降精度。
3. 投机解码是纯加速,带字节级等价保证
权重里带着模型的 MTP 头(完整的 Flash-Next 层,512 专家和独立索引器)。投机解码的规矩是:头只提议,主干逐个验证,只有主干本来就会输出的 token 才被发出——温度 0 时输出与串行贪心解码字节级一致,每个 release 都验证这条保证。
0.6.0 起加了第二个草稿源:prompt lookup——答案里已出现过的文本片段,后续 token 直接成链提议、一步验证。工具调用参数、文件路径、引用正在编辑文件的代码,大多是这种复制——恰好是 Agent 输出花 token 的地方。两条草稿路径同享字节级等价保证。
这就是 decode 6.1 秒 vs 对手 11-14 秒的来源,而且没有任何质量代价。
三、主执行链路
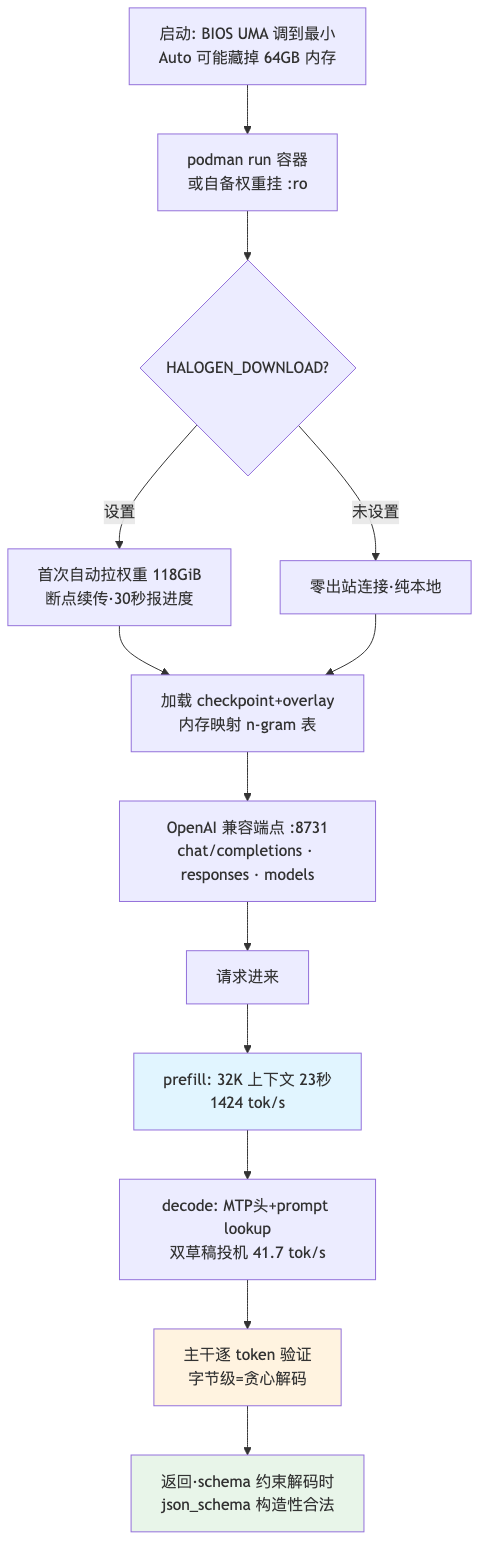
性能账本(32K prompt + 256 回答):
| 方案 | 精度 | prefill | decode | 总计 |
|---|---|---|---|---|
| halogen-flash 0.5.3 | 5.53 bpw | 23.0s | 6.1s | 29.1s |
| EngramHalo.cpp | 3.71 bpw | 103.7s | 14.3s | 118.0s |
| ROCmFP4 | 5.51 bpw | 104.7s | 13.2s | 117.9s |
| CIRU-IU4 | 5.96 bpw | 143.7s | 11.0s | 154.7s |
README 对这组数字的处理值得夸:主动声明 decode 列是软的(无法确认两家竞品是否开了投机解码),但 prefill 列没有歧义——而这恰恰是长上下文场景的大头。给所有对手按最乐观的投机解码折算,总计仍约 110 秒 vs 它的 31 秒。
四、核心模块架构
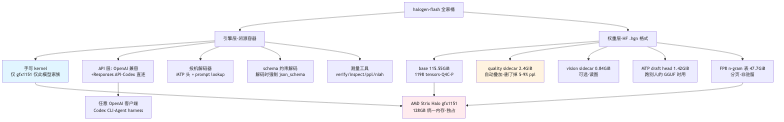
几个模块值得单独说:
Bring your own GGUF(0.7.0 起):引擎能直接打开这个模型的 llama.cpp GGUF(unsloth 的 UD-IQ4_XS 等),启动时无损重排进内存——你下好的文件不用转换,直接跑在这些手写 kernel 上,同样的投机解码和字节级保证。GGUF 不带这个引擎能用的草稿头,所以配发 mtp.hgn(主干自己的 31 个头张量)。
schema 约束解码(0.8.0 起):response_format: json_schema 在解码时强制生效,回复对 schema 合法是构造出来的,不损失速度——对 Agent 工具调用是刚需能力。
vision 是可选件:视觉塔单独一个文件,不开时图像路径是"不存在"而非"被禁用"——纯文本部署的行为与之前字节级一致。读图代价明确标价:1080p 一张约 11.8 秒,4K 要 105 秒且不比 1440p 读得更好。
测量工具:verify/inspect/ppl/niah 都做成镜像的 mode,你自己的量化或 GGUF 都能测——让你用算术核对它的声明,而不是靠信任。bpw 就是从 checkpoint 自己的张量表算出来的,QUANT.md 给了逐家族推导。
五、数据与状态流
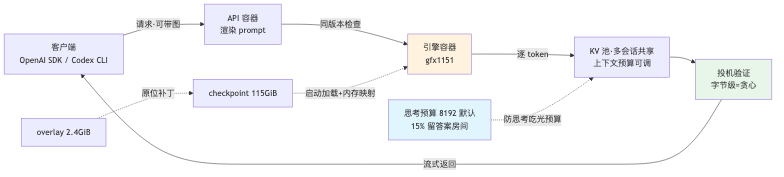
几个状态管理细节体现了工程完成度:
思考预算的"答案房间"(0.11.0):这模型思考很凶,早期版本预算耗尽会返回空 content + 一段没人看的 reasoning——Agent harness 的压缩摘要任务因此整批失败重试。现在预算剩 max(1024, 15%) 时自动闭合思考块,保证 capped 请求以答案收尾。
版本配对检查:API 容器和引擎容器拆分部署时,旧 API 配新引擎会把图片发成没有像素的占位符——0.5.8 起引擎拒绝这种情况,双方首行日志打版本,/health 同时报告两个版本。
内存状态透明:启动最后一行报告给系统留了多少内存;不设 HALOGEN_DOWNLOAD 时容器零出站连接;sidecar 过旧会明确说而不是悄悄用。
六、跨端边界
- 硬件边界是绝对的:gfx1151 之外的任何 GPU、任何平台,这套东西不存在。不是"不支持",是"为别的硬件没有写"
- 格式边界:.hgn 权重打不开 transformers/vLLM/llama.cpp;反过来引擎能开这个模型的 GGUF——单向兼容,方向是"你搬进来",不是"我搬出去"
- 客户端边界几乎不存在:OpenAI API 全兼容 + Responses API 让 Codex CLI 直连(含工具调用),Agent harness 零改造接入
- 网络边界可选:
HALOGEN_DOWNLOAD不设则零出站连接——完全离线的部署形态 - 姊妹方案:halogen 还有 27B checkpoint 产品线;组织名 peonist-ai 下其它模型未覆盖
七、配置边界
- 必须做:BIOS 里把 UMA/专用显存调到最小显式值(不是 Auto!某些板 Auto=64GB,会藏掉一半内存导致权重装不下)——这个反直觉要求写在了 Quickstart 第一条
- 容器:一条命令起步,权重自动下载(118GiB,断点续传);tag 故意钉死版本——"钉住的 tag 让 bug report 可回答、坏 release 可回滚"
- 采样默认:镜像默认贪心(所有字节级保证的前提);想按模型卡推荐的采样(temperature=1.0/top_p=0.95/top_k=20)用环境变量设服务器默认,请求显式发的永远赢
- 显式拒绝优于静默:logprobs+stream、超范围参数、超 max_tokens 上限(65536)都是 400 报错而不是静默截断或钳制——每个被拒绝的请求都知道自己为什么被拒
- 内存边界:默认配置吃掉 128GB 的大半,官方建议"给它一台专属机器";非要共享有 recipe,但后果写明——内存挤兑时双方可能满 CPU 停转几分钟,不是崩溃也不需要重启
八、扩展点
- 上下文扩展:KV 池支持多会话共享;1M 上下文 opt-in;sparse-attention 预算可从 2048 提到 4096(检索测试找回默认漏掉的埋点事实,代价 7% prefill 速度)——后两者明确标注不保字节级等价
- 可组合上下文预览(0.9.0):压缩后的会话可复用保留的工具结果而不重读——Agent 长会话的成本优化,同样 opt-in、不保等价
- GGUF 生态接入:任何人量化的这个模型(限定 expert/dense 格式组合)都能直接跑,草稿头由官方补发
- Agent 部署友好:仓库带 AGENTS.md——给部署/驱动/调试这个 server 的 AI Agent 看的浓缩文档,Agent 接管运维是官方支持路径
- 自测量路径:verify/inspect/ppl/niah 开放给自己的量化产物——它不只是要你信,是给了你验证的工具
九、风险点
- 硬件锁定是生存风险。你的投资绑定在一块消费级芯片的一个 SKU 上。Strix Halo 生态若萎缩,这个项目没有 Plan B——通用引擎慢 4 倍但哪里都能跑,这个快 4 倍但只能在这块芯片上活
- 引擎闭源。权重 Apache-2.0(量化值全部自产,这点干净),但 kernel 层是黑盒:字节级等价保证靠 release 验证声明,你无法审计实现。信任模型是"测出来的"(自带测量工具)而非"读出来的"
- 权重许可继承上游。README 明说:这些是 Qwen 的衍生作品,商用前自己核对原模型许可条款,这里不授予上游没有的权利
- 对比数字的边界要自己守住。竞品数字来自它们自己机器的公开发布,功率墙、内存配置未必一致;decode 列的投机状态不可考。prefill 的 4 倍是最硬的,其余要在自己的盒子上复测
- 内存是紧平衡。默认配置几乎吃满 128GB,与其它服务共居一机时可能出现"双方满 CPU 停转数分钟"的内存挤兑——不崩溃但极像死机,排障成本高。官方给的办法是给独居
- 118GiB 的下载与 disk 税。首次部署就是一场耐力赛(虽然断点续传+进度日志做得好);checkpoint+sidecar 必须成对保存,删 sidecar 不报错、悄悄掉 5-9% 质量——只在启动日志提一行
- 投机解码的适用边界:prompt lookup 只在单请求生成时开启;n>1、logprobs+stream 等场景显式拒绝而非降级——并发多用户形态下它的优势会缩水,这是单机单用户向的设计
记住
halogen-flash 的方法论是拒绝通用性税:为一款 GPU、一个模型家族手写每个 kernel,把省下的通用性开销全部换成绩效——prefill 快 4 倍、精度还比对手高,投机解码带字节级等价保证,质量的损失精确修在 0.09% 的张量上。
它同时示范了闭源专用方案怎么赢回信任:bpw 用算术可核对、竞品数字主动标"软"、不满足的请求拒绝而非静默、每个声明附测量工具——不是让你信,是让你能查。
代价同样清晰:一块芯片、一个模型、闭源引擎、118GiB 的家底。这是一台好机器,但它不是一匹能换鞍的马。
参考资源
- 引擎:https://github.com/peonist-ai/halogen-flash-server(容器分发,含 QUANT.md、AGENTS.md、测量模式文档)
- 权重:https://huggingface.co/peonist-ai/halogen-qwen3.8-flash-next(checkpoint + quality/vision/MTP sidecars)
- 上游模型:Qwen/Qwen3.8-Flash-Next(商用许可需自行核对)
- 社区:官方 Discord(自测数字对账)