
鸿蒙迁移的五阶段流水线:从逆向 Spec 到闭环验证
前言:迁移的活,为什么这么难
鸿蒙生态在涨。
存量 Android 应用要迁 ArkTS。
人工重写?语义鸿沟太大。Java 那套面向对象,ArkTS 是声明式 UI 加函数式,两码事。
只求编译通过?运行时全是雷:内存泄漏、ANR、兼容性问题。
出了 bug 查根因?可能横跨框架层、引擎层、业务逻辑,人工排查按小时算。
这套五阶段 AI 流水线,就是把迁移拆成可插拔、可度量的工业化流程。
一句话:逆向 Spec → 正向生成 → 智能定界 → 质量内建 → 反馈闭环。
一、全景图
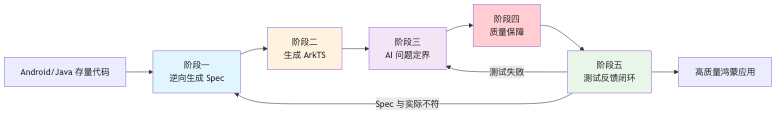
两个回流箭头是灵魂:
- 测试失败 → 回到阶段三定界
- 测试发现 Spec 和实际 API 行为不符 → 回到阶段一改 Spec,后面全部重跑 " 这就是"自愈"。每次迭代,首次生成质量都在涨。
二、阶段一:逆向代码为 Spec
目标:把 Android 字节码或源码,转成平台无关的结构化规格描述。这是后续一切生成的唯一事实来源。
为什么不用 AST?
AST 只有语法结构,没有业务语义。生命周期依赖、异步回调、跨层数据绑定,全丢。
所以用多叉树增强 Spec:
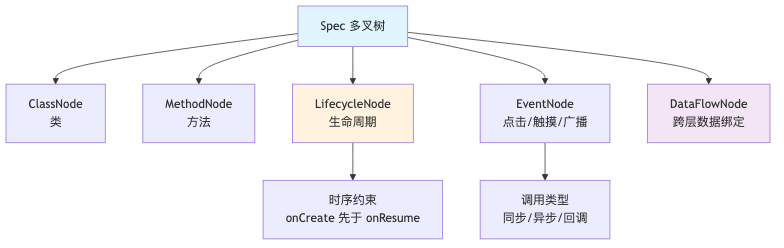
三个关键设计:
节点类型扩展:除了类和方法,加生命周期节点、事件节点、数据流节点。Activity 的生命周期、按钮的点击、跨层的数据绑定,都是一等公民。
边带语义:父子边标注调用类型(同步/异步/回调)和时序约束(onCreate 必须在 onResume 之前)。
多叉树合并:多 dex、多 aar 做依赖解析,合成统一调用图。OkHttp 这类三方库裁掉内部细节,只留业务入口和框架回调。
AI 加持两处:
- 混淆代码的"反混淆命名推测",让标识符可读
- 对比历史迁移案例,自动标注平台差异风险点——比如 Android 的 PendingIntent 和鸿蒙的 WantAgent 差在哪
输出:JSON 格式的 Spec 树,含方法签名、调用链、数据流边、平台敏感标记。
三、阶段二:Spec 生成 ArkTS
目标:把 Spec 编译成可跑的 ArkTS,兼顾性能、可维护性和平台惯用法。
两块核心技术。
技能库:不是模板填充
"Skills"是代码生成策略库。一个 Skill 管一种常见模式——列表渲染、网络请求、数据库操作。
每个 Skill 封装:
- ArkTS 代码骨架
- 资源引用规范(string.json、media)
- 状态管理最佳实践(@State、@Link、@Provide)
- 性能优化指令(LazyForEach、@Reusable)
生成器按 Spec 节点类型动态组合 Skill。冲突怎么办?约束求解。列表同时要下拉刷新和上拉加载?自动合并 Refresh 和 List 组件。
多 Agent 动态编排
三个专业 Agent,一个编排器:
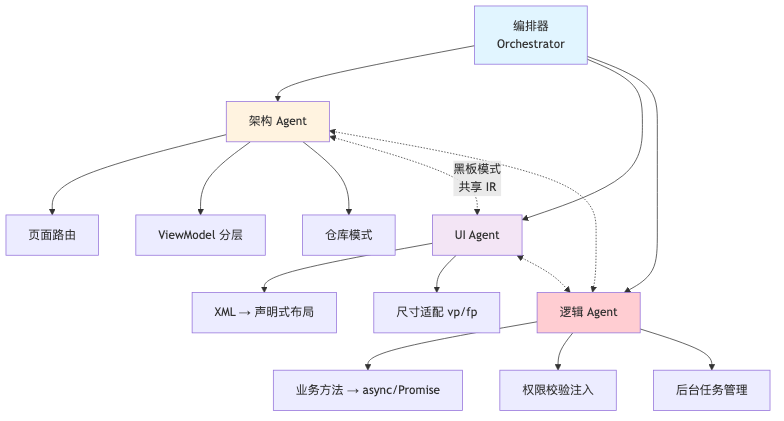
分工:
- 架构 Agent:路由、分层、仓库模式
- UI Agent:XML 布局转 ArkTS 声明式,处理 vp/fp 适配
- 逻辑 Agent:业务方法转异步风格,注入权限校验和后台任务管理
联动例子:逻辑 Agent 发现要调相机,立刻触发 UI Agent 生成权限弹窗占位代码,同时通知架构 Agent 注入 Permissions 依赖。
Agent 之间用黑板模式,共享中间表示(IR),支持迭代修正。
实测数据:200+ 页面迁移,自动生成约 75% 代码量。剩 25% 是平台特性——分布式流转、卡片服务,还得人来。
四、阶段三:AI 辅助问题定界
目标:测试或灰度阶段出了缺陷,快速定位根因,给出能直接用的修复建议。
端云协同架构:
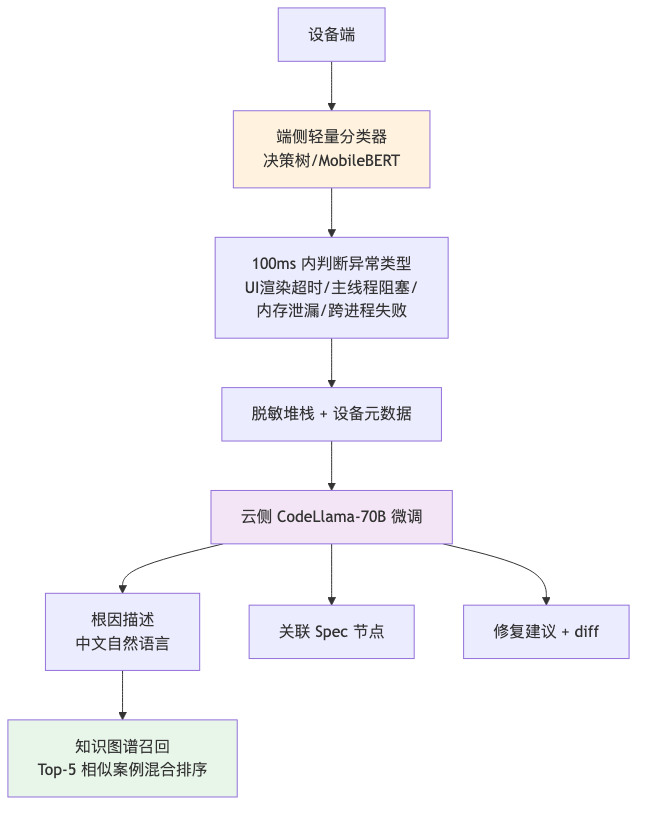
端侧:轻量分类器(决策树或 MobileBERT),实时抓崩溃日志、ANR trace、内存水位。100ms 内判断异常类型。
云侧:预训练代码大模型(CodeLlama-70B 微调)做根因分析。模型喂了大量鸿蒙源码和官方 FAQ。输出三样东西:
- 根因描述(中文人话)
- 关联的 Spec 节点(定位到阶段一某条调用边)
- 修复建议(带代码 diff)
关键创新:"异常-修复对"知识图谱。历史定界案例结构化存储,新异常来了先图检索召回 Top-5 相似案例,再和 LLM 生成结果混合排序。幻觉显著减少。
实践数据:定界时间从平均 2.5 小时降到 15 分钟,修复建议采纳率 68%。
五、阶段四:质量内建
目标:不光"能跑",还要"跑得稳、跑得久",达到企业交付标准。
三层防线:
1. 静态规范自动修复
鸿蒙 Lint 规则集:命名、注释、资源引用、性能陷阱。扫描 + 规则驱动重写引擎自动修。
例子:没关的 Preferences 实例,自动包 try-finally。
2. 功能测试增强
结合 Spec 自动生成 UI 遍历脚本(UIAutomator)和接口契约测试(OpenAPI)。验证页面跳转、数据回显、异常兜底是否符合 Spec 定义。
3. DFX 专项
- 稳定性:Monkey + 故障注入(低内存、弱网、杀进程),盯崩溃率
- 性能:启动耗时、帧率、CPU 占用自动采集,和基线比。超阈值触发阶段三的性能定界
- 兼容性:鸿蒙 3.0/4.0/5.0 + 多分辨率,云真机集群并行
整个阶段嵌进 CI/CD,每次代码变更自动触发全量检查。质量门禁。
六、阶段五:测试反馈闭环
目标:测试资产随代码一起演进,反哺前面所有阶段。
两个 AI 能力:
测试 Spec 自动生成:从阶段一的 Spec 里提边界条件——空数据、极长字符串、并发回调顺序。结合鸿蒙 API 约束(@Entry 组件必须有 build 方法),自动生成测试规格,覆盖正常路径、异常路径、并发场景。
AI 测试用例生成:把测试 Spec 转成可执行脚本(@ohos.test.uitest 或 Hypium)。用 Fuzzing 策略变异输入参数,自动构造断言——包括预期抛出的异常类型。
闭环机制:
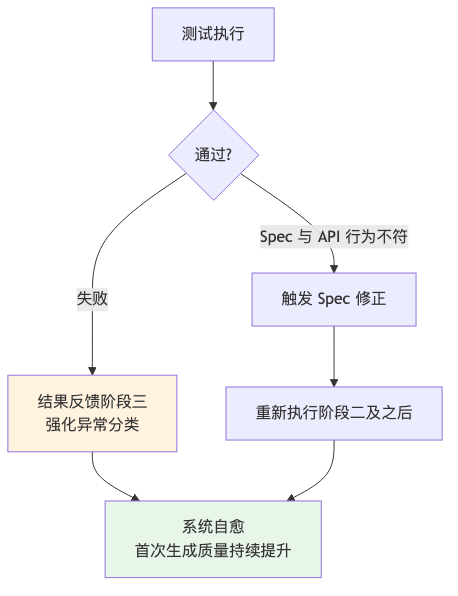
两条反馈路径:
- 测试失败 → 喂给阶段三的定界模型,异常分类越来越准
- 测试发现 Spec 和实际 API 行为不符(比如鸿蒙某版本改了回调顺序)→ 触发 Spec 修正 → 重跑阶段二之后的所有步骤
这就是基于测试失败的自动回滚与重生成。迁移系统因此有"自愈"能力。
七、值得抄的三件事
抛开鸿蒙,这套体系有三个设计值得任何迁移/生成类项目参考:
1. Spec 作为唯一事实来源
不直接从代码生成代码,中间必须过一层结构化 Spec。语义无损、可审计、可回溯。生成错了改 Spec 重生成,而不是补丁摞补丁。
2. 多 Agent 的黑板模式
三个 Agent 共享中间表示,而不是流水线串联。逻辑 Agent 的需求能实时触发 UI 和架构 Agent 联动。这是编排,不是接力。
3. 测试失败作为训练信号
测试不是终点,是反馈源。失败案例强化定界模型,Spec 偏差触发重生成。数据飞轮转起来。
八、演进方向
- 端侧大模型下沉:阶段三的定界能力部分移到端侧,离线也能快速诊断
- 多语言支持:Spec 抽象泛化,iOS(Swift)和 Web(JS)也能迁鸿蒙
- 自适应阈值:基于历史项目数据动态调质量门禁,减少误报
记住
人工重写迁移不动,只求编译通过满地是雷。
逆向 Spec 保证语义无损,多 Agent 编排拆解复杂任务,端云协同把排障从 2.5 小时压到 15 分钟。
测试闭环让系统自愈——每次迭代,首次生成质量都在涨。
附:核心数据速览
| 指标 | 数值 |
|---|---|
| 阶段二代码自动生成率 | ~75% |
| 问题定界时间 | 2.5 小时 → 15 分钟 |
| 修复建议采纳率 | 68% |
| 实测迁移规模 | 200+ 页面 |