
Hypit:一句话克隆爆款视频成 100 个变体
前言
" 刷到一条爆款视频,老板说"照这个给我来 50 条"。
以前的流程:拆解脚本 → 找素材 → 剪辑 → 改字 → 再来 49 遍。现在的流程是——把视频丢给你的 Coding Agent:
/hypit Clone this video: /path/to/video.mp4
Hypit 做的事,是给 AI Agent 一套做视频的语言和系统。它克隆的不只是脚本,是完整的工作流:素材、字幕、B-roll、特效,全部可编辑、可复用、可批量出变体。
- 仓库:https://github.com/hypit-ai/hypit
- 官网:https://hypit.ai
- 协议:Apache-2.0(附条件),框架免费、无水印、无按次渲染费
- 热度:Trendshift 日榜 #1
一、项目身份
Hypit 是什么:给 AI Agent(Claude Code、Codex 等)的视频创作框架。装一个 Skill,Agent 就获得理解视频、生成素材、合成成片的生产能力。
一句话说清楚:
丢进一条视频,Agent 产出的是一份完整的工作流——素材、字幕、B-roll、特效,全部锚定在"词"而不是"秒"上,可改可跑可量产。
两个容易被误会的点,README 自己先澄清了:
- 克隆是最快的入口,不是唯一的入口。可以从官方模板起步,也可以直接描述需求让 Agent 从零写工作流
- 生成模型是可选项。工作流可以只用字幕、动效图形和代码渲染的视觉素材合成成片——一个生成 API 都不调,一分钱生成费不花
二、核心思路:视频的源代码化
Hypit 最有意思的设计决策是一个时间轴观念的翻转。
传统剪辑工具的时间轴以秒为单位——字幕在第 3.2 秒出现,特效在第 7.5 秒触发。改一句台词,后面所有时间点全要手工重排。
Hypit 的中间表示是 SVML(一种源码格式),所有视觉元素锚定在词上:字幕跟着某个词出现,图形落在某句话的某个单词上。效果是:
改一行台词,时间轴自动重排(timing re-flows itself)。
这是把"前端工程化"的思路搬进了视频生产:视频有了源代码,就有了 diff、有了复用、有了批量变体——正如它官网演示的那样,左边 SVML 源码,右边实时渲染。
多语言本地化是这个设计的直接受益者:同一条视频出十个语言版本,重写一句台词,节奏自动跟上。
三、主执行链路
一条参考视频进来,到成片出来,链路是这样:
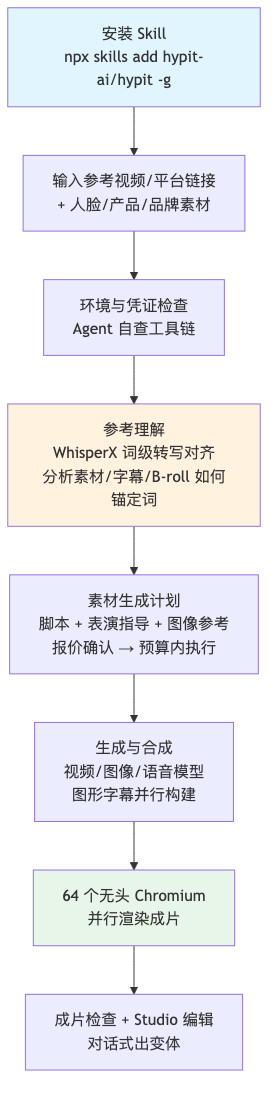
几个环节值得单独说:
词级对齐是理解的基础。WhisperX 先把口播转成带时间戳的词序列,Agent 才能把"字幕第几个词弹出、图形落在哪句话"这些细节读出来。官方示例里甚至用了 Google Video Intelligence 和 YOLOv8 的人脸框做说话人感知的字幕——谁在说话,字幕就染谁的颜色。
花钱前先报价。Agent 在任何付费调用之前,会列出账号、计划工作量、费率和预估成本,你确认了才跑。改账号、改范围、改预算,都会触发新的确认。这个设计对 Agent 自动化产品很有参考价值——成本决策留在人手里,执行才交给 Agent。
渲染不用传统剪辑引擎,用浏览器。64 个无头 Chromium 进程并行渲染——合成层就是前端代码,这也解释了为什么"纯代码渲染视频"可以完全不调生成模型。
四、核心模块与子模块
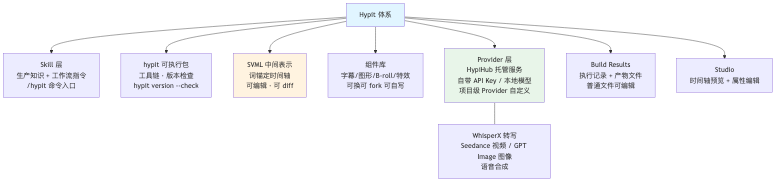
模块划分里有三个关键取舍:
Skill 和可执行包分离。Skill 供生产知识,hypit 包供工具,两者有独立的更新通道,更新互不破坏项目。
Provider 是开放协议,不是绑定服务。官方推荐 HypiHub 托管服务,但你自己的 API Key、私有部署、甚至本地模型都能接——告诉 Agent 服务名和 API 文档,它会写一个项目级 Provider。没有供应商锁定。
产物是普通文件。项目、理解记录、决策、成片全在本地文件系统里,"你的项目以普通文件保持可编辑"——不是藏在某个编辑器的私有工程里。
五、跨端边界
- Agent 端:任何支持 Skills 的 Coding Agent(Claude Code、Codex 等),项目目录任意,不需要 clone 仓库
- 模型端:HypiHub 托管 / 自带 Key / 本地模型三选一,可混搭
- 渲染端:本地无头 Chromium,64 进程并行——渲染算力在你自己机器上,不按次付费
- 服务边界:框架本身免费(Apache-2.0),费用只发生在你选择的模型服务上,由各家自己的账号计费
六、数据与状态流
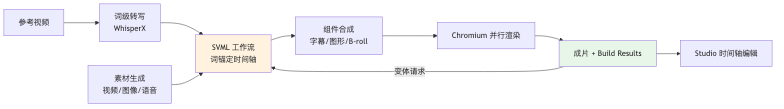
状态的核心是 SVML 工作流文件:它既是理解的产出,又是合成的输入,还是变体的基座。出变体时,可复用的素材直接复用,只重新生成变化的部分——这是它敢说"一条工作流 100 个变体"成本能压住的原因。官方示例里,20 秒的足球梯队视频(2 个视频 A-roll + 1 张人像 + 10 张 B-roll + 词级字幕 + 动效 + 配乐)单条成本 $1.15,换主播、改排序、换人物主题,各出一条克隆。
七、配置边界
- 安装一次:
npx skills add hypit-ai/hypit -g,全局生效,项目放哪都行 - 版本双通道:Skill 和可执行包独立更新,
hypit version --check自查 - 凭证最小暴露:服务凭证在需要时才向 Agent 提供,账号和预算在付费前明确约定
- 项目自包含:理解、决策、素材、工作流都在项目目录里,换 Agent、换机器可迁移
八、扩展点
- 组件:字幕、图形、B-roll、特效都是组件——换主播不动字幕,用库里的、fork 改造、或完全自写。组件跟随视频项目走,想分享就打成带版本的 tarball 或发到自己 npm scope,进入官方分发需要单独提案
- Provider:任何模型服务都能通过项目级 Provider 接入,Agent 按文档自己写连接
- 变体策略:改主持人、改开头钩子、改产品、改语言、改宽高比——组合爆炸的空间在这五个维度上
- 典型玩法(官方给的场景):Meta 广告库里的获胜广告当天换产品出 50 个 hook 变体;TikTok Shop 一天一个 SKU 复用同一结构;两周素材疲劳后只换开头、正文不动
九、风险点
- 克隆爆款有版权灰区。工作流结构、节奏、镜头语言的克隆相对安全,但直接复用他人的素材、人声、品牌元素会踩线。克隆结构不等于克隆内容——这是使用时的基本判断
- 成本控制依赖"报价确认"的纪律。机制设计了付费前确认,但如果无脑放权给 Agent 跑批量变体,$1 一条 × 100 变体 × 多轮迭代也会滚起来。预算上限要真的设
- 渲染吃本地算力。64 个 Chromium 并行是渲染快的原因,也是门槛——低配机器跑大批量会很慢
- 生成质量受模型制约。示例用的 Seedance 2 Mini、GPT Image 2 这些模型在持续换代,今天的效果上限不等于明天的,反过来也一样——换了模型,工作流可能要重新调
- 附条件的 Apache-2.0。"with conditions" 意味着不是纯 Apache,商用前读一下 LICENSE 附加条款
- Trendshift 日榜 #1 的热度衰减。项目很新,API 和 SVML 格式可能还在快速演进,生产依赖前盯 release notes
记住
Hypit 的核心不是"AI 生成视频"——是给视频建立源代码:素材、字幕、特效锚定在词上,改一行台词,时间轴自动重排。
克隆爆款只是最快的入口;真正值钱的是那条可编辑、可复用、可批量出变体的工作流。
一条 20 秒视频 $1.15,64 个 Chromium 并行渲染,结构不动、素材轮换——内容工业化的下一步,是把爆款拆成可 diff 的代码。
参考资源
- GitHub:https://github.com/hypit-ai/hypit
- Quickstart:https://hypit.ai/quickstart/
- 官方示例:ranking-football / podcast / interview(含 SVML 源文件与成本明细)