
把 Laya 决策引擎装进幽兰笔记本:一份 RK3588 上的完整部署方案
前言
Laya 是一个 33 毫秒出决策的 System 1 引擎——但那个数字是 T4 GPU 的。手头一台幽兰笔记本(格蠹科技 RK3588 方案,ARM64,无独立显卡),能不能跑?跑起来什么性能?怎么把它变成一台离线的工单分流机? " 这篇是完整的部署方案。结论先说:能跑,单次判断预期亚秒级,把它当"离线决策盒子"完全成立;但预加载策略和性能预期要按笔记本的规矩重新算。
一、两边的家底
先盘点硬件和模型,方案才不是空中楼阁。
幽兰本这边:
- SoC:瑞芯微 RK3588,8 核 ARM64(4×Cortex-A76 2.4GHz + 4×A55),8nm
- NPU:6TOPS,支持 INT4/INT8/INT16/FP16 混合运算
- 内存:LPDDR4X(16GB 版本),无独立 GPU
- 系统:Debian 系 Linux(太乙镜像,内核 5.10/6.x),aarch64 用户态
- 关键约束:算力靠 CPU(A76 核)+ 可选 NPU,没有 CUDA
Laya 这边:
- 三个 checkpoint:
laya(ModernBERT-large,421M)、laya-multilingual(mmBERT,322M)、laya-typed-decisions(421M) - 官方 CPU 参考数据:单问 193-464ms——注意那是服务器级 x86 大核
- 依赖:Python 3.10+,torch 2.14、transformers 5.x、huggingface_hub 1.x
- 权重 Apache 2.0,HuggingFace 可下
匹配度判断:Laya 是编码器小模型,不是生成式大模型。322M 参数 fp32 约 1.3GB 内存,多问一次前向传播——这正好落在 RK3588 CPU 能吃的范围里。比起在幽兰上跑 7B 大模型(Ollama 那条路),Laya 对这台机器友好得多。
二、选型决策:哪个 checkpoint,什么精度
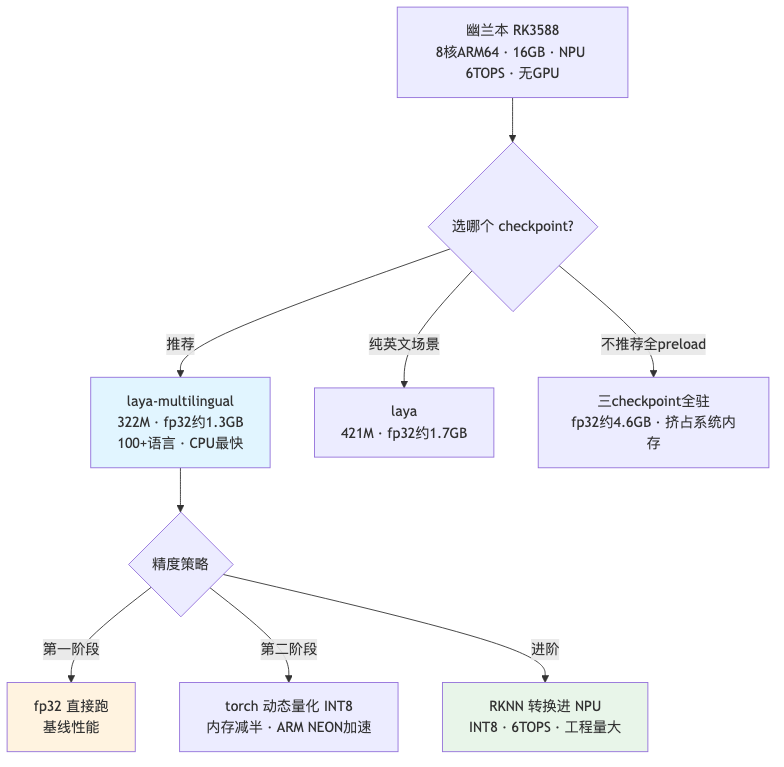
三条选型结论:
checkpoint 选 multilingual。322M 参数最小、CPU 上官方数据就最快(32.8ms 是它),多语言覆盖还最广。纯英文场景才考虑 421M 的英文版。
预加载只驻一个。Router(preload=True) 全驻三个 checkpoint,fp32 合计约 4.6GB——16GB 内存的本子跑得动,但系统+桌面+服务一挤就紧张。正确姿势是 laya.load() 直连单 checkpoint,绕过 Router 的多模型调度;或者 Router(max_loaded=1) 懒加载模式,语言切换时付重建成本(ARM 上会比官方 CPU 数据更痛,见风险节)。
精度分两阶段。先用 fp32 拿基线数据,再上 torch.ao.quantization 动态 INT8 量化——ARM NEON 对 INT8 有原生加速,编码器模型量化后通常掉点很小。NPU 路线作为进阶,不放在第一周。
三、部署主链路
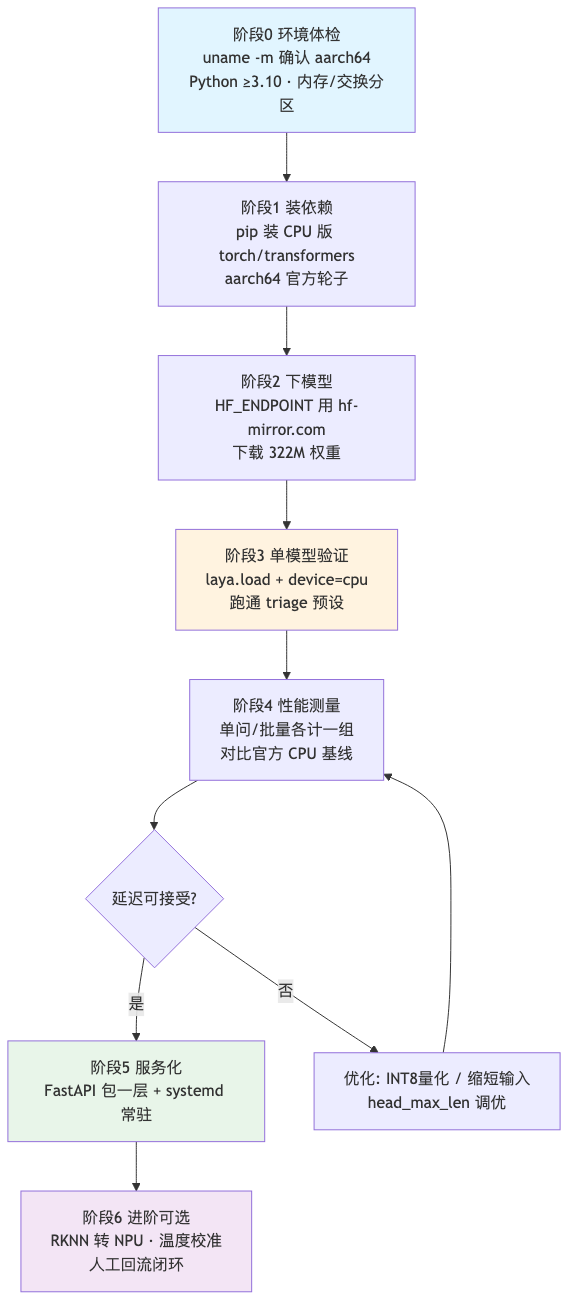
阶段 0:环境体检
uname -m                # 必须是 aarch64
python3 --version       # ≥ 3.10,太乙镜像默认 3.11 可用
free -h                 # 确认可用内存 ≥ 4GB
内存紧张就先建交换分区(幽兰 wiki 有现成的 swapfile 教程),下载和加载峰值时有缓冲。
阶段 1:依赖安装
PyTorch 对 linux_aarch64 有官方轮子,但装 CPU 版避免拖无用的 CUDA 依赖:
pip install torch --index-url https://download.pytorch.org/whl/cpu
pip install laya
如果某个版本的 aarch64 轮子缺货,退路是 pip install torch --index-url https://pypi.org/simple 直接从 PyPI 拉,或者用系统包管理器的 python3-torch 先顶着(版本可能不满足 2.14,此时锁定 laya 依赖版本或从源码编译 torch——编译在小核上很慢,尽量避开)。
阶段 2:模型下载
国内网络直连 HuggingFace 不稳,用镜像:
export HF_ENDPOINT=https://hf-mirror.com
python3 -c "from huggingface_hub import snapshot_download; snapshot_download('convaiinnovations/laya', subfolder='multilingual')"权重可以下载到笔记本后再离线拷入,laya.load 支持本地路径。
阶段 3:单模型验证
import laya

agent = laya.load("convaiinnovations/laya", subfolder="multilingual")  # 或本地路径

state = {"message": "我的支付失败了两次,今天必须解决"}
result = agent.predict(state, laya.triage_questions())
print(result["answers"])
跑通即完成冒烟测试。这一步顺便验证 tokenizer、模型加载、前向传播整条链在 ARM64 上没有架构相关的坑。
阶段 4:性能测量(关键阶段)
用 timeit 分别测:单问延迟、10 问批量延迟、以及 Router 懒加载模式下的语言切换成本。在幽兰上测出来的数字才是幽兰的数字——官方 CPU 基线(193-464ms)来自服务器 x86,C920… 不对,是 A76 核心单核性能低于服务器大核,预期单问落在 0.5-2 秒区间。这个数字决定了它适合什么场景:后台批量分流没问题,实时对话内联判断要掂量。
阶段 5:服务化
FastAPI 包一层 HTTP 接口,systemd 常驻,开机自启:
[Service]
ExecStart=/usr/bin/python3 -m uvicorn laya_api:app --host 0.0.0.0 --port 8300
Environment=HF_HUB_OFFLINE=1
Restart=on-failure
HF_HUB_OFFLINE=1 很重要:模型已在本地,禁用联网检查既加速启动又让笔记本彻底离线可用。
四、运行时架构
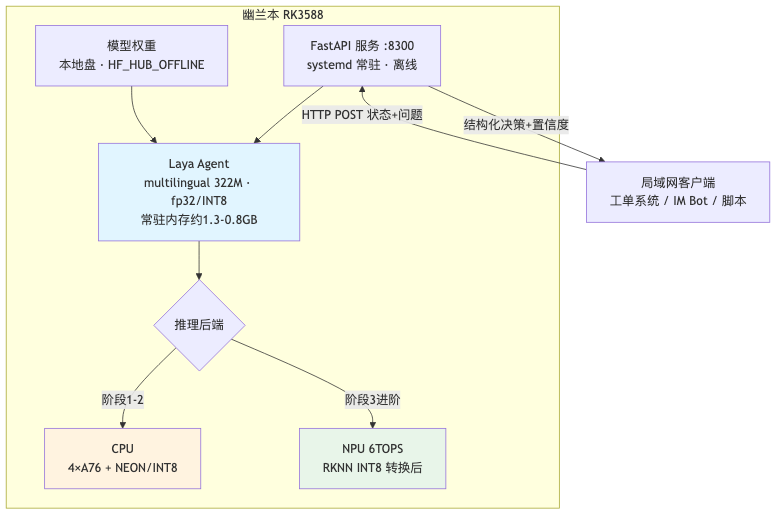
部署形态是局域网决策盒子:笔记本放角落,工单系统、IM Bot、脚本通过 HTTP 把状态和问题丢过来,拿结构化决策回去。数据不出内网——这也是把它装进一台笔记本而不是调云端 API 的核心理由。
五、数据与状态流
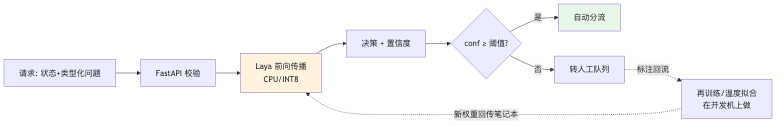
闭环里有个不对称设计:低置信样本的标注回流和再训练不在笔记本上做——RK3588 撑不起训练,开发机上跑,新的温度参数和权重回传部署。幽兰本只承担推理,这是它和云端方案分工的边界。
六、配置边界
- 必须配:CPU 版 torch、
HF_HUB_OFFLINE=1、只驻一个 checkpoint - 按需配:
torch.set_num_threads(4)绑定 A76 大核(A55 小核别参与推理,给系统留活路);批量大小按内存实测调 - 不要配:Router 全量 preload(内存账不划算);GPU 相关的一切环境变量;NPU 第一周就上(先拿 CPU 基线)
七、进阶:NPU 路线与性能天花板
CPU 路线的天花板测出来后,两条加速路按性价比排序:
第一优先:动态 INT8 量化。改动两行代码,内存近乎减半,ARM NEON 的 INT8 点积有硬件加速,编码器模型精度损失通常在 1% 以内。先做这个。
第二优先:RKNN 转 NPU。瑞芯微的 RKNN-Toolkit2 支持 PyTorch→ONNX→RKNN 的转换链,BERT 类模型有现成先例,6TOPS INT8 算力把延迟压到两位数毫秒是合理预期。代价是工程量大:算子支持要逐个核对(ModernBERT 的部分新算子可能要改写)、量化校准集要自己准备、精度回归要重跑。这是"值得做但别先做"的路线——先确认这个部署值得长期投入,再投 NPU 适配的工程。
八、风险点
- 依赖版本链是最大的坑。Laya 要求 torch 2.14 + transformers 5.x + Python 3.10+,aarch64 的轮子覆盖可能有缺口。开工前先在幽兰上验证
pip install torch --index-url .../whl/cpu能装上,装不上整个方案要降级到源码编译或锁旧版 laya - 延迟预期要重设。官方 193-464ms 是服务器 x86 的数,A76 上 0.5-2 秒是合理预期。它改变的是场景适配:后台分流、批量打标没问题;对话中的内联判断会拖节奏
- 懒加载的语言切换惩罚放大。官方 CPU 上切换重建 7.4 秒,A76 核更慢。混语言流量 +
max_loaded=1是最差组合——要么固定单 checkpoint,要么接受驻两个的内存代价 - 散热与降频。笔记本形态无风扇(RK3588 幽兰版被动散热),持续批量推理会撞温度墙降频,吞吐会随时间漂移。批量测试要跑 30 分钟以上看稳态,不是看峰值
- 量化掉点必须回归。INT8 和 NPU 转换都要在自己的业务数据上重跑准确率和 ECE——Laya 的置信度是门控依据,量化后校准漂移会直接改变"自动执行 vs 转人工"的分流比例
- 内存挤兑。桌面环境 + 浏览器 + 1.3GB 常驻模型,16GB 也可能紧张。生产形态建议关桌面、纯 headless 跑服务,把内存留给模型
记住
RK3588 跑 Laya,匹配度比想象中好:编码器小模型 + 单次前向传播,正好绕开了笔记本最弱的两项——显存和生成算力。
部署主线三句话:CPU 版 torch + 单 checkpoint 常驻 + FastAPI 盒子化;性能不够先上 INT8 量化,NPU 是值得但靠后的选项。
最重要的是重设预期:这台盒子的正确位置是内网里的离线分流器——每秒几个判断、亚秒级延迟、数据不出门。拿它对标 T4 的 33 毫秒,是问错了问题。
参考资源
- Laya:https://github.com/NandhaKishorM/laya(CPU 基线数据见仓库 BENCHMARKS.md)
- 幽兰笔记本:https://www.nanocode.cn/wiki/docs/youlan(交换分区、系统镜像等教程)
- RKNN-Toolkit2:瑞芯微官方 GitHub(NPU 转换链)