
给电子废品派活:把 Laya 装进 4GB 的 Z96A 云笔电
前言
" Sunniwell Z96A,原本是运营商云桌面(VDI)用的廉价云笔电,RK3568B2 方案,4GB 内存 + 32GB eMMC,二手市场上一两百块的东西,典型的"电子废品再就业"选手。
上一期给幽兰本(RK3588,8 核,16GB)做了 Laya 部署方案,这次换成 Z96A,难度完全不是一档:4 个 A55 小核、没有大核、内存只有 4GB——Laya 最小的 checkpoint 是 322M 参数,fp32 权重就占 1.3GB,再算上 PyTorch 运行时,内存账从第一页开始就是紧的。
结论先说:能跑,但 INT8 量化从"优化项"变成"入场券",性能定位是分钟级批量的离线分流器,不是在线服务。这篇把账算清楚。
一、先认硬件:这台机器弱在哪
| 规格 | Z96A | 对部署的含义 |
|---|---|---|
| SoC | RK3568B2,4×Cortex-A55 @2.0GHz | 只有小核,单核性能约是 A76 的一半以下 |
| 内存 | 4GB LPDDR4X | 核心瓶颈,见下一节的内存预算 |
| 存储 | 32GB eMMC | 放模型够用,但别拿它当 swap 主力(写入寿命) |
| GPU | Mali-G52 2EE | OpenCL 路线,对 BERT 类模型帮助有限 |
| 网络 | 仅 WiFi(RTL8822CS) | 无线部署,局域网盒子成立 |
| 系统 | 预装 Android 11,可刷 Armbian | RK3568 是主线支持最好的 RK SoC 之一 |
好消息有两条:RK3568 的主线 Linux 支持质量很高(CPU、显示、USB、WiFi 全部主线驱动,社区已有现成 Armbian 适配和设备树);A55 核虽然慢,但对"每分钟判几条"的场景,四核并行完全够用。
坏消息只有一条,但致命:4GB 内存。方案的一切设计围着它转。
二、内存预算:这场仗的兵力清单
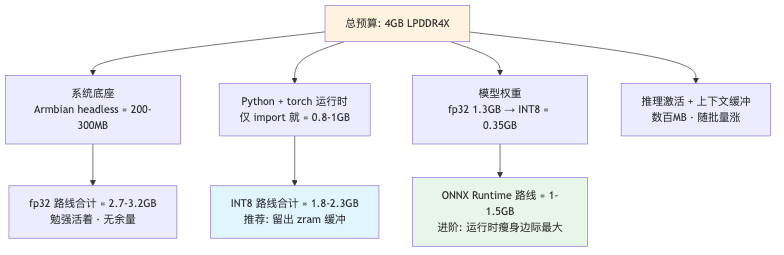
三条结论直接给出:
fp32 在这台机器上是自杀。权重 1.3GB + torch 运行时约 1GB + 系统 0.3GB,加起来 2.7GB 起步,激活和碎片一挤就撞墙,OOM killer 会替你做决定。
INT8 动态量化是入场券不是可选项。torch.ao.quantization.quantize_dynamic 两行代码,权重压到约 350MB,编码器模型精度损失通常 1% 以内——Z96A 上没有"先跑 fp32 基线"的奢侈,直接从量化开始,量化前的精度在开发机上测。
终极形态是甩掉 torch。torch 运行时那 1GB 是纯开销,导出 ONNX 用 onnxruntime 跑(aarch64 官方轮子,运行时占用小得多),总占用能压到 1-1.5GB——这是 Z96A 上边际收益最大的一步优化。
三、部署主链路
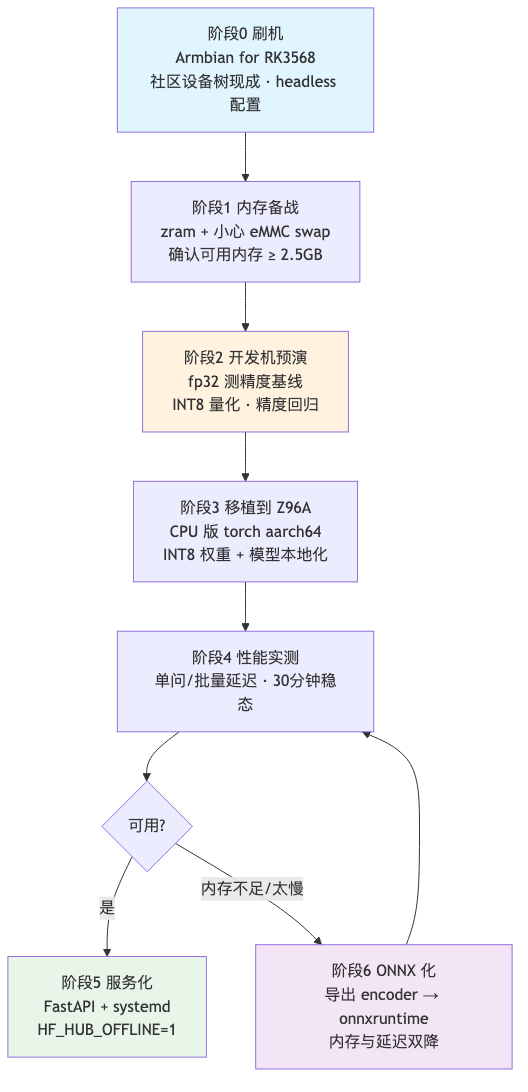
阶段 0:刷机
Z96A 的 Armbian 适配是现成的(社区 bingo1991/kemp233 的设备树、armbian build 分支),RK3568 主线内核 5.19+ 后显示、WiFi、USB 都在。刷机走 USB OTG 线刷或 eMMC 直写,调试串口(1500000 波特率)留一条后路。部署形态选 headless:不装桌面,SSH 进去跑服务——省下的几百 MB 内存都给模型。
阶段 1:内存备战
zram 是 4GB 机器的标配(压缩内存交换,比 eMMC swap 快且不伤寿命)。如果一定要落盘 swap,控制在小分区、低优先级,把 eMMC 写入当保险而不是常态。目标:free -h 确认可用内存 ≥ 2.5GB 再开始装模型。
阶段 2:开发机预演(关键)
别在 Z96A 上做第一次实验。x86 开发机上先完成三件事:跑通 laya 官方示例确认用法、对自有业务数据测 fp32 精度基线、做 INT8 量化并回归精度和 ECE(置信度校准会因量化漂移,门控阈值要重标)。量化后的权重文件拷给 Z96A——开发机干活,废品本上岗,各干各的。
阶段 3-4:移植与实测
Z96A 上装 CPU 版 torch(aarch64 轮子),加载量化权重,实测两组数:单问延迟、10 问批量延迟。A55 @2.0GHz 的合理预期是单问数秒级——这意味着它不抢在线服务的活,接的是批量分流、夜间打标、低频工单分类这类"不着急但必须本地"的活。
阶段 5:服务化
FastAPI + systemd,和幽兰方案同款:
[Service]
ExecStart=/usr/bin/python3 -m uvicorn laya_api:app --host 0.0.0.0 --port 8300
Environment=HF_HUB_OFFLINE=1
Environment=OMP_NUM_THREADS=4
Restart=on-failure
四个 A55 全给推理没问题——这台机器没有"系统流畅度"要照顾。
阶段 6:ONNX 化(进阶)
内存告警或延迟不满意时的主攻方向:把 encoder 导出 ONNX,onnxruntime 的 aarch64 版本带 INT8 优化,运行时内存占用和推理延迟双降。tokenizer 部分(transformers 的)保留 CPU 执行即可,那部分不是开销大头。
四、运行时架构
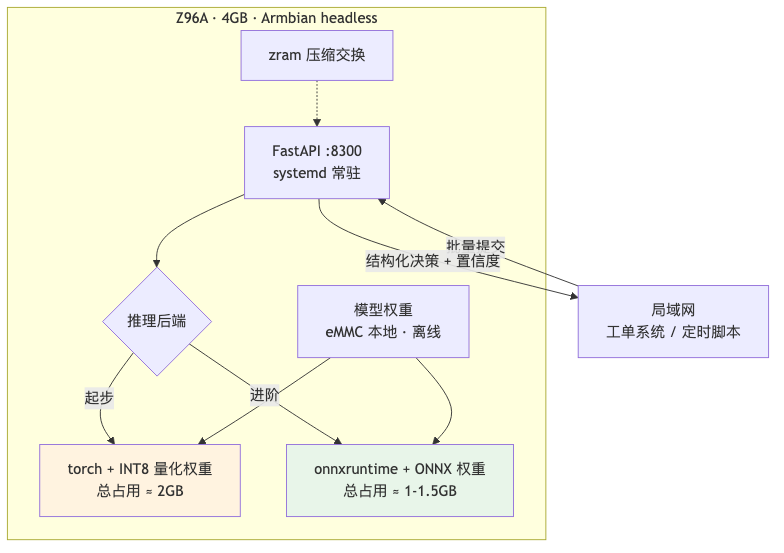
五、数据与状态流
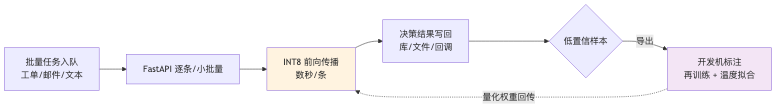
再训练闭环依然不在 Z96A 上做——4GB 内存连想都不要想训练的事。它只做推理,标注回流在开发机完成,量化后的权重回传部署。
六、配置边界
- 必须配:Armbian headless、zram、INT8 权重(开发机量化后拷入)、
HF_HUB_OFFLINE=1、OMP_NUM_THREADS=4 - 不要配:fp32 直跑(内存不允许)、eMMC 大分区 swap(写入寿命)、桌面环境(内存刺客)、torch 以外的 CUDA 一切
- 量力配:批量大小从 1 开始逐步加,撞内存即回退;ONNX 化放在实测数据说话之后
七、它到底适合干什么
Z96A + Laya 的合理画像,跟幽兰方案对比就清楚了:
| 幽兰本(RK3588) | Z96A(RK3568) | |
|---|---|---|
| 单问延迟预期 | 0.5-2 秒 | 数秒 |
| 内存余量 | 充裕 | 紧张,INT8 起步 |
| 合适场景 | 近实时分流(亚秒级宽容) | 批量打标、夜间分流、低频判断 |
| 定位 | 内网决策盒子 | 电子废品再就业的离线批处理节点 |
一句话:Z96A 版 Laya 是"深夜跑批的苦力"——每天晚上把白天的工单分好类、把垃圾邮件标好、把紧急度打完分,早上你来收结果。这个活不需要快,需要的是便宜、离线、不用心疼。
八、风险点
- 4GB 是硬天花板。fp32 不可行、批量大小受限、任何内存泄漏都会快速致命。上线前必须做 24 小时连续批量压测,盯 RSS 曲线——曲线爬坡就是泄漏,systemd 定时重启只是遮羞布
- INT8 精度回归不能省。量化后 ECE 漂移会改变"自动执行 vs 转人工"的实际分流比例,阈值必须在量化后重新标定——开发机上用业务数据做,不是拍脑袋
- aarch64 依赖链风险。torch 2.14 / transformers 5.x 的 ARM64 轮子覆盖有不确定性;如果版本对不上,退路是锁旧版 laya 或直接走 ONNX 路线绕开 torch 版本地狱
- A55 没有大核托底。系统任何后台任务(日志压缩、apt 自动更新)都会直接抢推理核心的周期——服务化时把系统定时任务错峰,或干脆用 cgroup 隔离
- WiFi-only 的部署脆弱性。断网即失联,服务化后要配 SSH 内网常连和开机自启自恢复;生产环境慎用无线,USB 网卡是廉价备份
- eMMC 寿命。32GB 消费级颗粒,日志和 swap 管不好一年就磨穿。日志限速轮转、swap 走 zram、模型权重只读挂载
记住
一两百块的云笔电废品,装上 Laya 变成什么?一个数秒一条、只干批处理苦力、但完全离线的决策节点。
4GB 内存决定了这套方案的所有姿态:INT8 是入场券不是优化项,ONNX 化是最大边际收益,再训练永远在别的机器上做。
电子废品再就业的正确姿势,不是让它假装现代设备,而是给它找一个跟它体量匹配的活。深夜批量分流,就是 Z96A 的活。
参考资源
- Laya:https://github.com/NandhaKishorM/laya(BENCHMARKS.md 有官方延迟基线)
- Z96A 硬件文档与 Armbian 适配:https://github.com/yjun123/e-waste/tree/master/sunniwell-z96a
- 社区设备树:bingo1991/rk3568_laptop_sunniwell_z96a、kemp233/armbian-build-sunniwell-Z96a
- torch 动态量化:PyTorch 官方文档 quantization 章节