
Laya 决策引擎:一次前向传播 33ms,从 LLM 手里拿回判断
前言
" 让 LLM 判断"这封邮件是不是钓鱼"、"该转给哪个部门"、"用户是不是要流失",你得到的是什么?
一段文字。然后你写代码去解析这段文字,祈祷它格式稳定,祈祷它没有幻觉,祈祷置信度那句话是真心话。
Laya 换了一条路:判断不该生成,判断该测量。它是一个不自动回归的"系统 1"决策引擎——输入状态和类型化问题,一次前向传播直接输出结构化决策。单问题 33 毫秒(T4 实测),没有任何文字生成,没有东西可解析,就没有东西可幻觉。
- 仓库:https://github.com/NandhaKishorM/laya
- 模型:HuggingFace convaiinnovations/laya(三个 checkpoint)
- 协议:Apache 2.0,权重开放,自托管零成本
pip install laya,Python 3.10+
一、项目身份与应用方向
Laya 是什么:基于 ModernBERT / mmBERT 的多语言类型化决策模型,用强化学习对严格正则评分规则训练(RLCD),让置信度在统计上有意义。
一句话说清楚:
对任意状态(文本/邮件/工单/JSON)提出类型化问题,一次前向传播 33 毫秒返回结构化决策和有统计意义的置信度——专为高频、低延迟的分流判断场景设计。
三种决策原语,覆盖绝大多数判断类需求:
| 原语 | 输出 | 典型场景 |
|---|---|---|
choice | 顶标签 + 各选项概率 + 置信度 | 部门分流、意图分类 |
score | 序数量表上的期望档位 + 分布 | 紧急程度、挫败感、危害等级 |
noul | 校准后的 P(true) | 钓鱼检测、越狱检测、流失风险 |
四个开箱即用的生产预设:智能模型路由(决定请求走小模型还是旗舰模型)、实时提示词防护(越狱/注入/泄露)、内容审核、客服工单分流。这几个场景的共同点:每条请求都要判一次,判错有代价,但不需要写一篇文章——这正是 LLM 最不划算、Laya 最划算的地带。
二、核心思路:系统和系统的分工
README 里有个词很关键:System 1。借用卡尼曼的框架——
- System 2(慢思考):LLM 的生成,推理深但慢、贵、不稳定
- System 1(快直觉):条件反射式的判断,快、便宜、可批量
现在的架构把两类问题都喂给 System 2,等于让最贵的员工去干分流台的活。Laya 的主张是把高频判断下沉到 System 1:分类、评分、是非判断这些结构化决策,用一个 421M 参数的编码器一次前向传播解决,让 LLM 专注真正需要生成和推理的部分。
工程上这个分工有个隐形前提:System 1 的置信度必须可信——因为下游要拿它决定"自动执行还是转人工"。这正是 RLCD 训练的卖点:用严格正则评分规则做强化学习,概率不是装饰,是校准过的。实测在留出数据上做逐类型温度拟合后,ECE 从 0.466 降到 0.081。置信度 ≥0.85 自动执行、低于则转人工——这个门控模式才立得住。
三、主执行链路
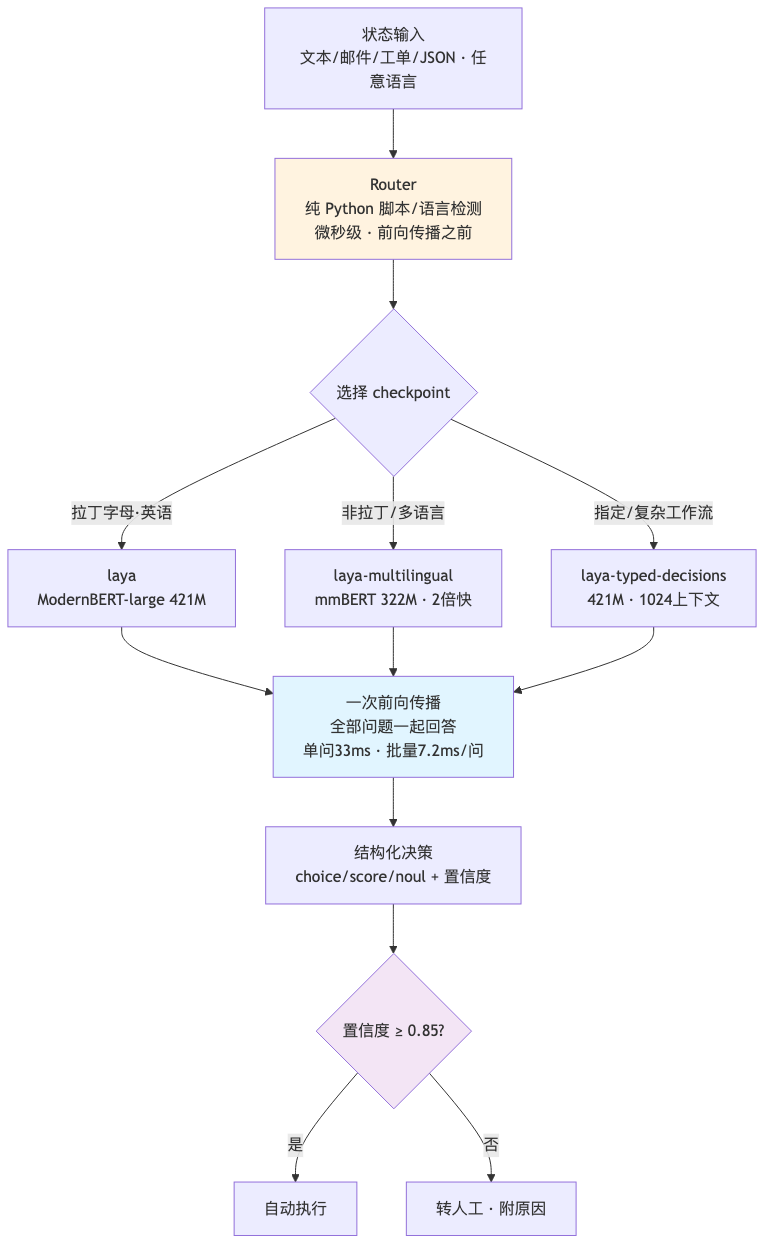
Router 是整个设计里最诚实的部分。基准测试暴露了一个反直觉的事实:英文 checkpoint 遇到高棉语,准确率 0.000,置信度却高达 0.952——模型错了还自信满满,置信度门控救不了你。所以路由决策必须做在前向传播之前:Router 用纯 Python 检测脚本和语言(<0.5 毫秒),不信任模型自己的判断。每个路由结果都带解释:"non-Latin script (devanagari, 100% of letters); the English checkpoint cannot read it"。
效果用数据说话(17,416 题、同一 T4、字节级相同的问题):英文 checkpoint 在非英语的 MASSIVE 意图识别上macro 只有 0.306,51 种语言只有 23 种可用;Router 模式拿到多语言 checkpoint 的 45/51,同时保住英文的 0.783。一次调用,两个模型的好处都拿到。
四、核心模块与子模块
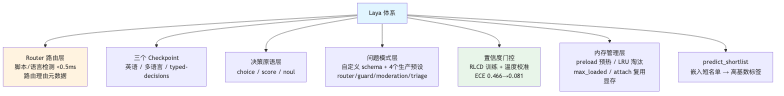
模块里两个细节值得展开:
内存管理是被真实流量教训出来的。默认 max_loaded=1 意味着流量在语言间交替时,每次切换都要重建模型——CPU 上中位 reloading 7.4 秒,T4 上 10.3 秒。生产解法是 Router(preload=True) 全部常驻,语言切换成本降到检测本身的微秒级;显存紧张可以 attach 复用已加载的 agent,或者 max_loaded=2 走 LRU。懒加载和预加载的差距,是每次切换 7-10 秒和32.8 毫秒的差距。
predict_shortlist 是给高基数场景的后门。标签超过 50 个(比如 Banking77 的 77 个意图)时,固定 token 预算摊到每个标签只剩 3-4 个 token,准确率崩到 0.425。短名单模式先用嵌入检索 top-k 标签,再对短名单跑一次前向传播——把硬分类问题变成"召回 + 精排"两段。
五、跨端边界
- 硬件:GPU 上 32.8ms 单问,CPU 上 193-464ms——CPU 也能用,但生产分流建议 T4 级起步
- 语言:51 种测试语言中 45 种可用(>3 倍随机基线),覆盖 100+ 语言声明
- 上下文:多语言/typed-decisions checkpoint 默认 1024(编码器 RoPE 可扩到 8192),英文 checkpoint 512——长文档判断注意预算
- 部署:
pip install即用,Colab 一键复现基准,HuggingFace Space 有在线 demo
六、数据与状态流
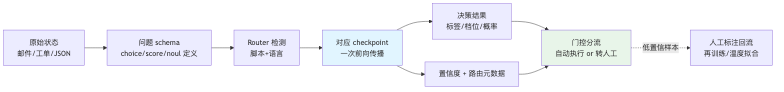
数据流里最有生产价值的闭环是那条虚线:低置信样本转人工后,标注结果可以回流用于再训练或温度拟合。置信度校准不是一次性交付,是持续运维——README 自己承认出厂 checkpoint 普遍过度自信,多语言版本甚至没带拟合好的温度参数,靠它做概率决策前必须先在自己的数据上拟合。
七、配置边界
- 必须配的:生产环境
preload=True(否则语言切换 7-10 秒);用概率做决策前做温度拟合 - 按需配的:
device="cuda"、max_loaded常驻数、head_max_len(高基数标签时提到 512) - 不用配的:路由策略(自动脚本检测,可
router.route()预检不跑推理)、明确指定 checkpoint 可覆盖路由
八、扩展点
- 自定义问题 schema:三个原语自由组合,criteria 支持结构化描述,一个 schema 就是一条业务判断规则
- 生产预设改造:router/guard/moderation/triage 四个预设的题目可以直接抄去改
- 微调特化:这是这个项目的核心玩法——README 坦白 base checkpoint 在 typed-decisions 上接近随机(0.362 vs 随机 0.318),0.766 的成绩来自在基准自己的训练集上微调。Laya 的定位是"一个适合特化的快速底座",不是开箱即用的零样本决策引擎——这是它少见的诚实
- 嵌入函数可换:
predict_shortlist的embed_fn接受任意 text→vector 函数,可以用自己领域的嵌入模型做召回 - 作为 LLM 系统的前置层:模型路由、提示词防护、审核三个预设,天然是 LLM 应用入口的守门员
九、风险点
- 零样本能力接近随机。这是最大的坑:不微调直接用 base checkpoint 做 typed-decisions,准确率 0.342-0.362,低于多数类基线 0.461。每个场景都需要微调或用预设,把 Laya 当零样本引擎引入必然翻车
- 高基数标签是架构性短板。77 标签时准确率 0.425(对比闭源对手 Jev 的 0.870),50+ 选项场景要么调
head_max_len,要么上短名单,要么拆成粗细两级问题——没有免费午餐 - 出厂校准不可信。两个 checkpoint 都过度自信,多语言版本连温度参数都没拟合。在拿到自己数据上的 ECE 数字之前,置信度只能参考不能做门控阈值
- 软分布弱于对手。argmax 准确率赢 Jev(0.766 vs 0.727),但概率分布与教师模型的匹配度输(soft acc 0.471 vs 0.580)——如果你的下游需要的是完整分布而不是 top-1,这是个真实代价
- 对比数据的立场。对 Jev 的数字全部来自第三方发表,本仓库未实测,样本和提示词不同;Jev 在 20+ 选项、开箱校准上有明确优势。选型时两边都要跑自己的数据
- 个人项目的持续性。作者是独立开发者(Buy Me A Coffee 挂在 README 上),虽然 Apache 2.0 + 权重开放保证了"拿走就用"的下限,但长期维护和模型迭代没有机构背书
记住
Laya 的核心主张一句话:判断不该生成,判断该测量。
类型化决策用编码器一次前向传播解决,33 毫秒,置信度经 RLCD 训练和温度校准后统计上可信——高频分流从 LLM 手里拿回来,让生成模型去干生成的事。
但记住它的自我定位:一个适合特化的快速底座,不是零样本决策引擎。不微调就上场,它的准确率会低于"全部归到最大类"这个笨办法——这一点,README 比很多竞品的宣传诚实得多。
参考资源
- GitHub:https://github.com/NandhaKishorM/laya
- 基准全文:仓库内 BENCHMARKS.md(51 语言逐语言明细,Colab 一键复现)
- 模型:https://huggingface.co/convaiinnovations/laya
- 作者复盘:《I built non-autoregressive decision models a year ago, then a frontier lab called it a...》(dev.to)