
LongHorizon-Harness:让 Agent 连续工作数十小时
前言:从单轮到持续,Agent 如何真正完成复杂任务
2026-08-25 10:17 GMT+8
AI Agent 的痛点:
模型决定 Agent 一轮能做什么。但问题来了:
- 一轮跑不完怎么办?
- 上下文刷新后怎么继续?
- 如何验证 Agent 真的完成了任务?
- 失败后如何恢复?
今天介绍 LongHorizon-Harness——一个面向 Computer-Use Agent 的 Loop Engineering 系统。
一句话说清楚:
工程化模型外部的执行闭环:规划 → 执行 → 验证 → 保存或恢复 → 重复,直到任务真正完成
一、项目概览
LongHorizon-Harness 是一个面向 Computer-Use Agent 的 Loop Engineering 系统。
一句话说清楚:
只需向 Claude Code、Codex、OpenCode 或 DeepSeek Harness 给出一次目标,即可让它跨桌面 App 与终端持续工作数十个小时
项目地址:https://github.com/AMAP-ML/LongHorizon-Harness 官网:https://lh-harness.pages.dev arXiv:https://arxiv.org/abs/2608.01964 开源协议:MIT
核心特性:
- ✅ 规划 → 执行 → 验证 → 保存或恢复 → 重复
- ✅ 支持桌面 App 与命令行一个连续任务
- ✅ 任意模型,任意 Agent 后端
- ✅ 三个角色:Manager、Executor、Auditor
- ✅ 数百个真实任务规模化验证
- ✅ 一条命令安装,开箱即用
核心价值:
模型决定 Agent 一轮能做什么。LongHorizon-Harness 负责工程化模型外部的执行闭环:下一步做什么、如何在真实电脑中验证、哪些进度可以保存,以及在失败或上下文刷新后如何继续。
二、核心理念:Loop Engineering
面向真实电脑环境的 Loop Engineering
向 LongHorizon-Harness 给出一个目标。它会不断把剩余工作拆成一项边界明确的任务,在正确的电脑界面中执行,检查真实结果,并把通过验证的进度带入下一轮。
Loop Engineering 流程图
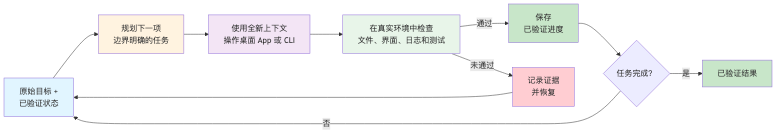
这就是 Loop Engineering:工程化 Agent 外部的执行、验证、纠错与恢复闭环,而不只是优化单轮 Prompt。
三、三个角色,一个闭环
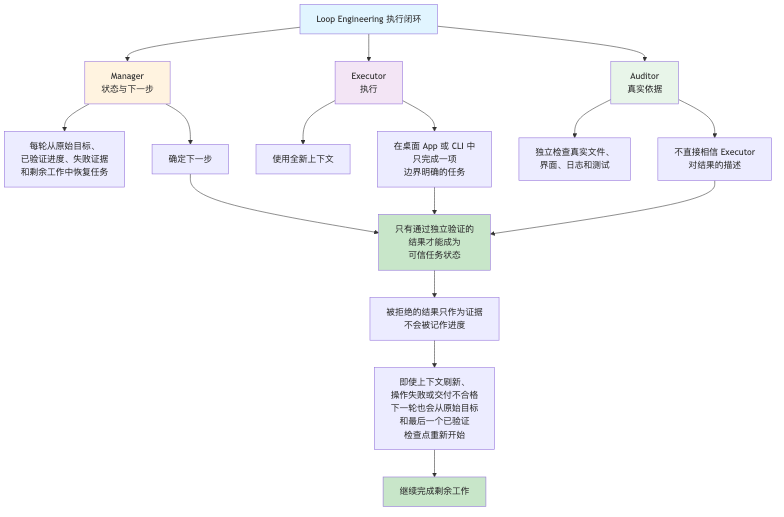
一个闭环,三种专注职责
三个角色是同一执行闭环内的职责边界,并不是三个各自维护不同任务版本的 Agent。
角色架构图
角色职责表
| 闭环职责 | 角色 | 负责内容 |
|---|---|---|
| 🧭 状态与下一步 | Manager | 每轮从原始目标、已验证进度、失败证据和剩余工作中恢复任务,并确定下一步 |
| ⚡ 执行 | Executor | 使用全新上下文,在桌面 App 或 CLI 中只完成一项边界明确的任务 |
| 🔍 真实依据 | Auditor | 独立检查真实文件、界面、日志和测试,不直接相信 Executor 对结果的描述 |
核心原则
只有通过独立验证的结果才能成为可信任务状态。
被拒绝的结果只作为证据,不会被记作进度。即使上下文刷新、操作失败或交付不合格,下一轮也会从原始目标和最后一个已验证检查点重新开始,继续完成剩余工作。
四、桌面 App 与命令行,一个连续任务
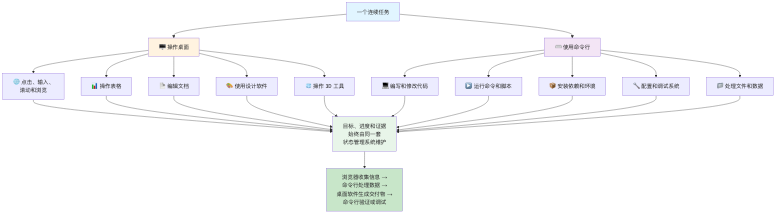
同时支持 GUI 和 CLI 工作流
一个任务可以先在浏览器中收集信息,再通过命令行处理数据,接着在桌面软件中生成交付物,最后回到命令行验证或调试。整个过程中,目标、进度和证据始终由同一套状态管理系统维护。
工作流对比图
实际应用场景
场景 1:数据可视化项目
- 在浏览器中收集数据
- 通过命令行处理数据
- 在 Excel 中生成图表
- 回到命令行验证结果
场景 2:Web 开发项目
- 在浏览器中查看需求
- 通过命令行编写代码
- 在桌面软件中编辑资源
- 在浏览器中测试效果
场景 3:系统配置任务
- 在文档中查看配置说明
- 通过命令行修改配置
- 在桌面软件中验证效果
- 在命令行中查看日志
五、任意模型,任意 Agent 后端
不绑定特定模型或 Agent 后端
现有模型和 Agent 可以通过配置接入,无需改变原来的工作方式。
架构分层图
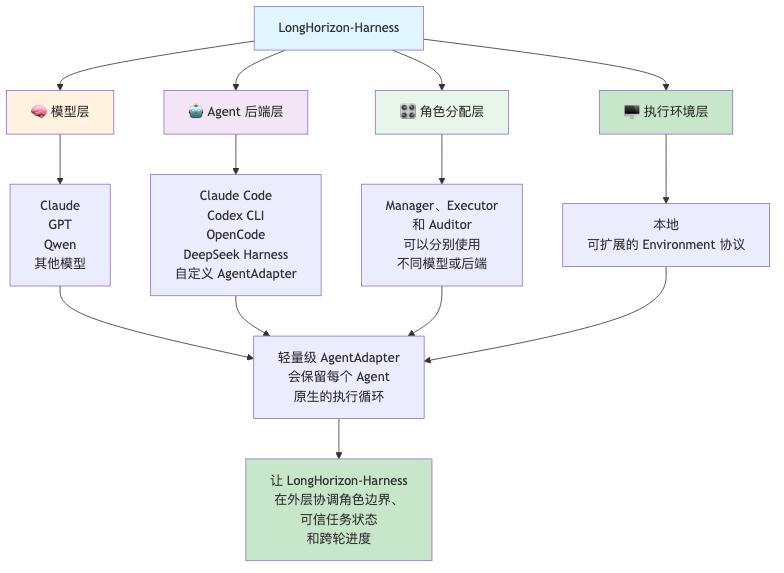
模型与后端支持
| 层级 | 支持选项 | |
|---|---|---|
| 🧠 | 模型 | Claude、GPT、Qwen,以及 Agent 后端提供的其他模型 |
| 🤖 | Agent 后端 | Claude Code、Codex CLI、OpenCode、DeepSeek Harness(dsh,第一阶段仅 CLI),以及自定义 AgentAdapter 实现 |
| 🎛️ | 角色分配 | Manager、Executor 和 Auditor 可以分别使用不同模型或后端 |
| 🖥️ | 执行环境 | 本地,并提供可扩展的 Environment 协议 |
灵活配置
三个角色既可以使用同一个模型,也可以组合不同模型和后端,在效果、速度和成本之间进行权衡。
示例 1:全部使用同一模型
[run]"
agent = "codex"
model = "gpt-5.6-sol"
示例 2:不同角色使用不同模型
[run]
agent = "codex"
model = "gpt-5.6-sol"

[run.roles.manager]
model = "gpt-5.6-sol"

[run.roles.executor]
model = "gpt-5.2-fast"

[run.roles.auditor]
model = "gpt-5.6-sol"
六、数百个真实任务,规模化验证
不只展示精心挑选的成功案例
LongHorizon-Harness 在数百个覆盖 GUI、CLI 和混合电脑环境的复杂任务中持续工作。
任务领域
| 任务领域 | 具体内容 |
|---|---|
| 🌐 Web 前端 | 开发、修复和验证网站与 Web 应用,结合浏览器交互、开发者工具和代码修改完成任务 |
| 📊 数据分析与可视化 | 处理数据、生成图表与仪表盘,并检查分析结果和可视化交付物 |
| 🛠️ 运维与调试 | 排查日志、网络、性能和服务故障,完成系统配置、诊断与修复 |
| 🎨 设计与图像处理 | 编辑视觉素材、匹配设计稿、处理图像并验证最终视觉效果 |
| 🎮 游戏与交互 | 构建、操作和调试游戏或交互式应用,检查交互逻辑与运行结果 |
| 📄 文档与演示 | 编辑文档和演示文稿,处理内容、格式、引用、布局和最终交付 |
| 🧊 空间推理 | 完成涉及空间关系、几何结构、精确放置和 3D 操作的任务 |
| 🖥️ 桌面与系统设置 | 操作桌面应用、文件和系统设置,完成跨软件的配置与管理工作 |
| 🔬 研究与教育 | 完成文献研究、课程作业、教学材料、表单和研究支持工作流 |
| 🎬 创意制作 | 制作演示、视频、音频及其他多媒体内容,并完成跨工具的素材处理 |
| ⚙️ 工程与计算 | 使用 CAD、EDA、科学软件、开发工具和云端或 DevOps 工具链完成专业任务 |
| 🎫 个人服务 | 处理活动票务、日常服务、游戏和视觉搜索等面向个人用户的工作流 |
| 🏛️ 行政与合规 | 完成办公、法律、政策敏感表单、机构流程和安全相关的提交任务 |
| 💼 商业与金融 | 处理市场分析、采购、贷款、销售、报销和其他需要跨应用核对的企业工作流 |
| 🏥 医疗健康 | 完成医疗质控、保险、免疫记录和结构化健康表单等工作流 |
七、评测结果
模型相同,执行后端相同,只改变 Harness
| 评测 | 指标 | Claude Code | LongHorizon-Harness | 提升 |
|---|---|---|---|---|
| WeaveBench(114 个任务) | PassRate | 51.8 | 80.7 | +28.9 |
| WeaveBench | Overall | 0.702 | 0.835 | +0.133 |
| OSWorld 2.0(108 个任务) | Binary | 2.8 | 8.3 | 3.0 倍 |
| OSWorld 2.0 | Partial | 21.5 | 35.2 | +13.7 |
| Terminal-Bench 2.1 | 成功率 | 69.7 | 77.2 | +7.5 |
所有结果均使用 Qwen 3.7-Plus 作为基础模型,并使用 Claude Code 作为执行后端。
性能提升总结
| 任务类型 | 提升幅度 |
|---|---|
| GUI + CLI 任务完成率 | 约 50% → 约 80% |
| 长时间桌面任务完整完成率 | 3 倍 |
| 代码与命令行任务成功率 | 69.7% → 77.2%(token 减少 24%) |
八、快速开始
一条命令,全程可见
安装
第 1–2 步每台机器只需做一次,第 3 步针对每个项目。之后在网页上运行任务(第 4 步)或用命令行运行(第 5 步)。
环境要求
| 用途 | |
|---|---|
| uv | 推荐的隔离安装方式。习惯用 pip 可以不装。 |
| Python 3.10 或更高版本 | 运行 Harness。uv tool install 自带 Python;用 pip 安装则使用你当前的。 |
PATH 上有一个 Agent 运行时:codex、claude、opencode 或 dsh | 真正执行任务。想按角色混用多个后端就安装多个。 |
| Node.js 20 或更高版本 | npm 分发的 computer-use 插件需要;DeepSeek Harness 本身目前要求 Node.js ^22.19.0 或 >=24.0.0。 |
1. 安装 LongHorizon-Harness
uv tool install lh-harness # 或:pip install lh-harness后续升级用 uv tool upgrade lh-harness 或 pip install --upgrade lh-harness。
2. 安装 computer-use 插件(可选)
任务不涉及 GUI 可以跳过。否则按你使用的 Agent 装对应的那个。
使用 Codex:
lh-harness plugin install codex-computer-use使用 Claude Code,或两个 Agent 都用:
lh-harness plugin install open-computer-use3. 生成项目配置
cd /path/to/your/project
lh-harness init
该命令会生成 ./.lh-harness/config.toml,默认不会覆盖已有文件;需要重新生成时用 lh-harness init --force。
4. 在网页上运行任务(推荐)
lh-harness web --workspace-root .该命令在 http://127.0.0.1:8799/ 打开工作台,所有操作都在这里完成。
5. 也可以用命令行运行任务
TASK="检查当前目录并总结其中的文件。"
lh-harness run --task "${TASK}" --agent codex
检查运行环境
lh-harness doctordoctor 是只读的,只报告 Python 运行时、Agent CLI、Node.js 和插件状态。
九、核心特性
1. Loop Engineering
工程化 Agent 外部的执行、验证、纠错与恢复闭环,而不只是优化单轮 Prompt。
2. 三个角色
Manager、Executor、Auditor 三个角色在同一执行闭环内各司其职,确保只有通过独立验证的结果才能成为可信任务状态。
3. 桌面 App 与命令行
同时支持 GUI 和 CLI 工作流,一个任务可以跨浏览器、命令行、桌面软件等多个界面连续完成。
4. 任意模型,任意后端
不绑定特定模型或 Agent 后端,现有模型和 Agent 可以通过配置接入。
5. 规模化验证
在数百个真实任务中验证,覆盖 Web 前端、数据分析、运维调试、设计图像、游戏交互等 15 个领域。
6. 一条命令安装
开箱即用,无需复杂配置,快速上手。
十、实际应用场景
场景 1:Web 开发项目
需求:开发一个响应式网站
使用 LongHorizon-Harness:
- Manager 规划任务:设计 UI → 编写 HTML → 编写 CSS → 测试响应式
- Executor 执行:在浏览器中查看设计稿 → 在命令行编写代码 → 在浏览器中测试
- Auditor 验证:检查代码质量 → 测试响应式效果 → 验证最终交付物
场景 2:数据分析项目
需求:分析销售数据并生成可视化报告
使用 LongHorizon-Harness:
- Manager 规划任务:收集数据 → 清洗数据 → 分析数据 → 生成图表
- Executor 执行:在浏览器中下载报表 → 在命令行处理数据 → 在 Excel 中生成图表
- Auditor 验证:检查数据完整性 → 验证分析结果 → 检查可视化质量
场景 3:系统配置任务
需求:配置和部署服务器
使用 LongHorizon-Harness:
- Manager 规划任务:查看文档 → 修改配置 → 测试配置 → 部署服务
- Executor 执行:在浏览器中查看文档 → 在命令行修改配置 → 在桌面软件中测试
- Auditor 验证:检查配置文件 → 测试服务运行 → 验证部署结果
十一、核心价值
1. 从单轮到持续
不只是优化单轮 Prompt,而是工程化整个执行闭环,让 Agent 能够持续工作数十个小时。
2. 独立验证
只有通过独立验证的结果才能成为可信任务状态,确保任务真正完成。
3. 自动恢复
即使上下文刷新、操作失败或交付不合格,下一轮也会从原始目标和最后一个已验证检查点重新开始。
4. 灵活配置
不绑定特定模型或 Agent 后端,可以根据需求灵活配置。
5. 规模化验证
在数百个真实任务中验证,覆盖 15 个领域,性能显著提升。
十二、总结
核心问题
AI Agent 的痛点:
- 一轮跑不完怎么办?
- 上下文刷新后怎么继续?
- 如何验证 Agent 真的完成了任务?
- 失败后如何恢复?
LongHorizon-Harness 的解决方案
1. Loop Engineering
- 规划 → 执行 → 验证 → 保存或恢复 → 重复
- 工程化 Agent 外部的执行闭环
2. 三个角色
- Manager:状态与下一步
- Executor:执行
- Auditor:真实依据
3. 桌面 App 与命令行
- 同时支持 GUI 和 CLI 工作流
- 一个任务可以跨多个界面连续完成
4. 任意模型,任意后端
- 不绑定特定模型或 Agent 后端
- 现有模型和 Agent 可以通过配置接入
5. 规模化验证
- 在数百个真实任务中验证
- 覆盖 15 个领域
- 性能显著提升
为什么选择 LongHorizon-Harness?
1. 从单轮到持续
- 让 Agent 能够持续工作数十个小时
- 不只是一轮 Prompt
2. 独立验证
- 只有通过独立验证的结果才能成为可信任务状态
- 确保任务真正完成
3. 自动恢复
- 即使上下文刷新、操作失败或交付不合格
- 下一轮也会从最后一个已验证检查点重新开始
4. 灵活配置
- 不绑定特定模型或 Agent 后端
- 可以根据需求灵活配置
5. 规模化验证
- 在数百个真实任务中验证
- 覆盖 15 个领域
- 性能显著提升
6. 开箱即用
- 一条命令安装
- 无需复杂配置
记住
模型决定 Agent 一轮能做什么。LongHorizon-Harness 负责工程化模型外部的执行闭环:下一步做什么、如何在真实电脑中验证、哪些进度可以保存,以及在失败或上下文刷新后如何继续。
规划 → 执行 → 验证 → 保存或恢复 → 重复,直到任务真正完成。
附:资源链接
项目资源:
- GitHub:https://github.com/AMAP-ML/LongHorizon-Harness
- 官网:https://lh-harness.pages.dev
- arXiv:https://arxiv.org/abs/2608.01964
- License:MIT
快速开始:
# 安装
uv tool install lh-harness            # 或:pip install lh-harness

# 安装 computer-use 插件(可选)
lh-harness plugin install open-computer-use

# 生成项目配置
cd /path/to/your/project
lh-harness init

# 在网页上运行任务(推荐)
lh-harness web --workspace-root .

# 也可以用命令行运行任务
TASK="检查当前目录并总结其中的文件。"
lh-harness run --task "${TASK}" --agent codex

# 检查运行环境
lh-harness doctor支持的后端:
- Claude Code
- Codex CLI
- OpenCode
- DeepSeek Harness(
dsh,第一阶段仅 CLI)
评测结果:
- WeaveBench:51.8% → 80.7%(+28.9)
- OSWorld 2.0:2.8% → 8.3%(3.0 倍)
- Terminal-Bench 2.1:69.7% → 77.2%(+7.5)