
Memmy:让所有 AI 都记得同一个你
前言
你现在的 AI 工作流可能是这样的:
Cursor 写代码,Claude Code 审查,Codex 生成函数,OpenClaw 跑任务。
每个工具都要重新认识你一遍。
项目背景重新讲,代码偏好重新说,上个月踩过的坑这个工具完全不知道。你的经验散落在五六个工具的会话历史里,互不相通。
Memmy 想解决的就是这件事:一个跨 Agent 记忆层,让所有 AI 记得同一个你。
- GitHub:https://github.com/MemTensor/memmy-agent
- 官网:https://memmy.bot
- 本地优先,开源免费
一、它是什么
先说清楚定位:Memmy 不只是又一个聊天助理,而是记忆底座 + 本地 Agent Runtime。
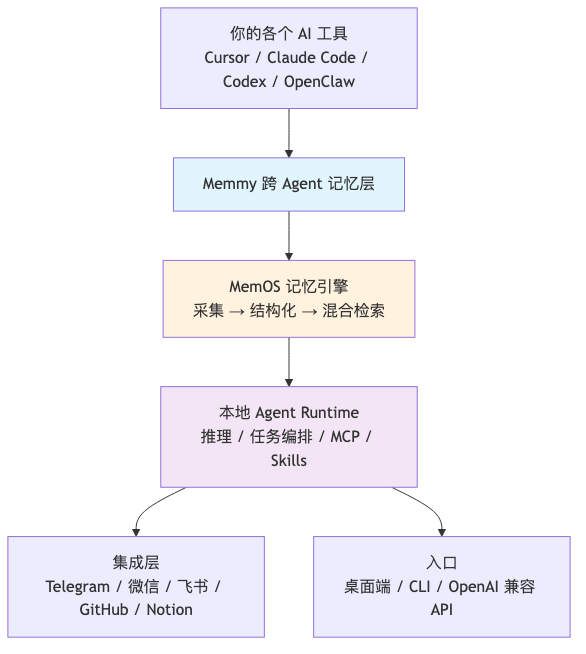
三个部件:
记忆层:统一个人记忆。支持导入已有 Agent 的历史对话,把散落的经验沉淀成可检索的长期记忆。底层是 MemOS 的结构化记忆引擎 + 混合检索。
Runtime:完整的本地 Agent 运行环境——推理、任务编排、MCP、Skills。也就是说它自己也能干活,不只是个记忆库。
集成层:Telegram、Discord、微信、飞书、钉钉,加上 GitHub、Gmail、Notion、Slack、Jira 这些生产力工具。
Local-first:数据在你机器上。这是记忆类产品的及格线,但它做到了。
二、和 OpenClaw、Hermes 的区别
这是最容易混淆的地方,一张表说清:
| 能力 | Memmy | Hermes | OpenClaw |
|---|---|---|---|
| 本地优先 | ✅ | ⚠️ | ✅ |
| 跨 Agent 共享同一份记忆 | ✅ | 🚫 | 🚫 |
| 接管外部 Agent 历史(Cursor 等) | ✅ | 🚫 | 🚫 |
| 为外部 Agent 装记忆 Skill | ✅ | 🚫 | 🚫 |
| 结构化记忆引擎(MemOS) | ✅ | ⚠️ | ⚠️ |
| 多渠道 / 多模型 BYOK | ✅ | ✅ | ✅ |
| " | |||
| 一句话:OpenClaw 和 Hermes 是"你的 AI 助理",Memmy 是"先记住你,再在记忆之上做 Agent"。 |
它不跟你现有的工具竞争,它给它们兜底。你不用换掉 Cursor,让 Cursor 接上 Memmy 的记忆就行。
三、上手要点
# 桌面端或 CLI 都行
# 导入历史上下文,把已有工具的对话喂进去

# 记忆的手动管理
memmy-memory add "项目的记忆策略:使用 MemOS 混合检索"
memmy-memory search "记忆策略"
三个入口:桌面 App、CLI/TUI、OpenAI 兼容 API。最后这个最实用——任何接受 OpenAI 接口的工具都能直接指到 Memmy 上。
四、我的判断:值得试,但想清楚三件事
1. 记忆的质量决定一切
记忆层产品最大的坑不是存不住,是记错了。三个月前的过时偏好,今天还在干扰输出,比没有记忆更糟。Memmy 的 MemOS 做结构化 + 混合检索,方向对,但新导入的历史对话噪声一定不小——前两周建议人工抽查它记了什么,发现记偏了立刻清。
2. 隐私是双刃剑
Local-first 是优点,但"一份记忆贯通所有工具"也意味着:这份记忆成了你数字画像的单点。它泄露,泄露的是全部上下文。本机磁盘加密、设备访问控制,用之前先配好。
3. 跨 Agent 记忆是真实需求,但生态还没定型
各家都在做自己的记忆方案(OpenAI 的 Memory、Anthropic 的 memory tool、各种 memory MCP)。Memmy 的差异化在于"不绑定任何一家、纯本地"。这个位置能不能立住,取决于它接入外部 Agent 的深度。现在上车成本不高,值得观察。
记住
每换一个 AI 工具就重新自我介绍一遍,这不是 AI 协作,是 AI 客服。
Memmy 是跨 Agent 的记忆底座:先记住你,再在记忆之上做 Agent。
它不和你现有的工具竞争,它给它们兜底——前提是你管好记忆的质量和隐私。
参考资源
- GitHub:https://github.com/MemTensor/memmy-agent
- 文档:https://memmy.bot/docs