
Paper2MD:一键将学术 PDF 论文转换为完整 Markdown
前言:学术论文的 Markdown 转换难题
阅读学术论文时,你是否遇到过这些问题?
- PDF 论文难以复制粘贴
- 公式、表格、图表无法正确转换
- 想要 Markdown 格式便于笔记和分享
- 手动转换耗时耗力
今天介绍 Paper2MD——一个 Claude Code 项目,一键将学术 PDF 论文转换为带图表嵌入的完整 Markdown。
一句话说清楚:
将学术 PDF 论文转换为带图表嵌入的完整 Markdown,无本地 GPU 依赖,全程 API 驱动,输出效果与原始 PDF 视觉一致
一、项目概览
Paper2MD 是一个 Claude Code 项目,将学术 PDF 论文转换为带图表嵌入的完整 Markdown。
一句话说清楚:
完整还原文字内容(含 LaTeX 公式、表格、双栏布局)+ 所有 Figure 截图,智能图表处理,高精度图表定位,整洁输出
项目地址:https://github.com/Deng-GuiFeng/Paper2MD 开源协议:MIT GitHub Stars:2 stars
核心特性:
- ✅ 完整还原 — 文字内容(含 LaTeX 公式、表格、双栏布局)+ 所有 Figure 截图
- ✅ 智能图表处理 — Table 由 VLM 转为 Markdown 文本,Figure 提取为 PNG 图片嵌入
- ✅ 高精度图表定位 — Qwen3.5-plus VLM 多轮质量评估,精确裁剪图表边界
- ✅ 占位符清理 — 自动移除 VLM 生成的图表占位符,消除重复 Caption
- ✅ 整洁输出 — 每篇论文独立子目录,互不干扰
- ✅ Claude Code 集成 — 1 个 agent + 2 个 skills,自然语言驱动完整流水线
二、核心架构
架构概览
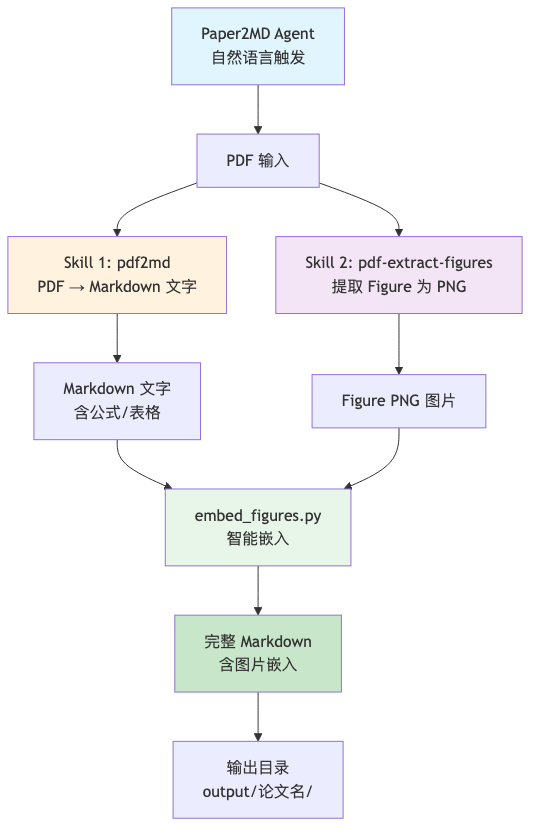
三大核心组件
1. paper2md agent
- 自然语言触发
- 协调两个 skills
- 完整流水线
2. pdf2md skill
- PDF 页面 → Markdown 文字(含公式/表格)
- 图片嵌入后处理
3. pdf-extract-figures skill
- 自动提取所有 Figure 为 PNG
- 支持仅提取 Figure 模式
三、完整工作流程
工作流程详解
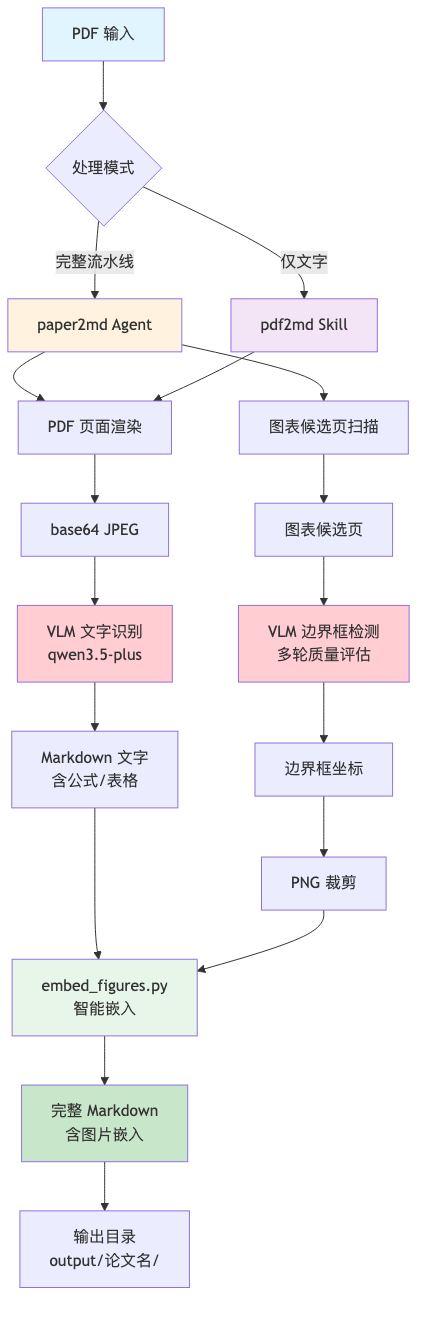
步骤详解
步骤 1:PDF 页面渲染
工具:pymupdf (fitz)
过程:
- 逐页渲染 PDF
- 转换为 base64 JPEG
- 传输给 VLM 处理
步骤 2:VLM 文字识别
工具:qwen3.5-plus VLM
过程:
- 接收 base64 JPEG
- 识别文字内容
- 转换为 Markdown 格式
- 流式输出,忽略 reasoning_content
输出:
- Markdown 文字
- LaTeX 公式
- 表格(转为 Markdown 文本)
步骤 3:图表候选页扫描
工具:pymupdf 文本扫描
过程:
- 扫描 PDF 每页
- 识别图表候选页
- O(n) 复杂度,无 API 消耗
优势:
- 快速定位图表
- 节省 VLM 调用
步骤 4:VLM 边界框检测
工具:qwen3.5-plus VLM
过程:
- 多轮质量评估
- 检测图表边界框坐标
- 精确裁剪图表边界
输出:
- 边界框坐标
- PNG 图片
步骤 5:智能嵌入
工具:embed_figures.py
过程:
- 插入图片引用
- 跳过已有 Markdown 表格
- 清理 VLM 占位符
- 消除重复 Caption
输出:
- 完整 Markdown
- 含图片嵌入
四、输出结构
目录结构
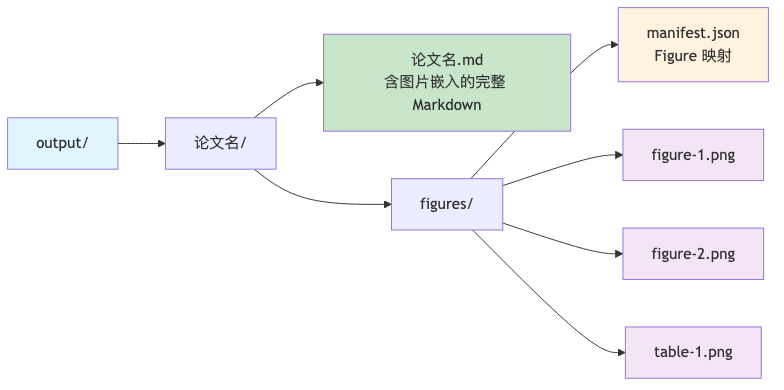
输出示例
output/论文名/目录结构:
output/
└── {论文名}/
    ├── {论文名}.md ← 含图片嵌入的完整 Markdown
    └── figures/"
        ├── manifest.json ← {"Figure 1": "figure-1.png", ...}
        ├── figure-1.png
        ├── figure-2.png
        └── table-1.png
manifest.json 示例:
{
  "Figure 1": "figure-1.png",
  "Figure 2": "figure-2.png",
  "Table 1": "table-1.png"
}
五、核心特性详解
特性 1:完整还原
文字内容:
- 完整识别所有文字
- 保留段落结构
- 支持双栏布局
LaTeX 公式:
- 自动识别数学公式
- 转换为 LaTeX 格式
- 保持公式结构
表格:
- Table 由 VLM 转为 Markdown 文本
- 保留表格结构
- 支持复杂表格
特性 2:智能图表处理
Table 处理:
- 由 VLM 转为 Markdown 文本
- 避免重复提取
- 保持可读性
Figure 处理:
- 提取为 PNG 图片
- 高精度裁剪
- 嵌入到 Markdown
优势:
- Table 可读性强
- Figure 视觉效果好
- 避免重复
特性 3:高精度图表定位
多轮质量评估:
- 第一轮:粗定位
- 第二轮:精确边界
- 第三轮:质量验证
精确裁剪:
- 边界框坐标
- PNG 裁剪
- 去除空白
输出:
- 高质量 PNG
- 精确边界
- 无多余空白
特性 4:占位符清理
VLM 占位符:
- 自动识别
- 智能移除
- 消除重复
重复 Caption:
- 检测重复
- 保留原始
- 清理冗余
整洁输出:
- 无冗余内容
- 结构清晰
- 易于阅读
特性 5:整洁输出
独立子目录:
- 每篇论文独立目录
- 互不干扰
- 便于管理
结构化输出:
- Markdown 文件
- figures 目录
- manifest.json
便于分享:
- 单个目录
- 完整内容
- 易于传播
特性 6:Claude Code 集成
1 个 Agent:
- paper2md agent
- 自然语言触发
- 协调完整流水线
2 个 Skills:
- pdf2md skill
- pdf-extract-figures skill
自然语言驱动:
- 简单直观
- 无需命令
- AI 辅助
六、快速开始
步骤 1:环境配置
# 创建 conda 环境
conda create -n paper2md python=3.11 -y
conda activate paper2md
pip install -r requirements.txt

# 配置 API Key(任选一种)
echo 'DASHSCOPE_API_KEY=your-api-key' > .env # 方式 A:.env 文件
export DASHSCOPE_API_KEY="your-api-key" # 方式 B:环境变量
步骤 2:使用
完整流水线(文字 + 图表 + 嵌入)
paper2md 是一个 Claude Code agent,通过自然语言触发,不支持 / 斜杠命令:
用 paper2md 处理 PDFs/paper.pdf
用 paper2md 将 PDFs/paper.pdf 转换成 Markdown,只处理前 5 页
用 paper2md 转换 PDFs/paper.pdf,参数 -m 10 --max-rounds 5
仅文字转换(不提取图表)
pdf2md 是一个 Claude Code skill,支持 / 斜杠命令:
/pdf2md PDFs/paper.pdf
/pdf2md PDFs/paper.pdf -m 5
步骤 3:参数
| 参数 | 默认值 | 说明 |
|---|---|---|
| -m / --max-pages | 0(全部) | 最大处理页数 |
| -c / --concurrency | 8 | 文字转换并发数 |
| --dpi | 300 | 渲染分辨率 |
| --max-rounds | 3 | 图表提取质量评估轮数(越高越精确,越慢) |
| --figures-only | 开启 | 仅提取 Figure,跳过 Table(agent 默认开启) |
七、技术栈
技术栈详解
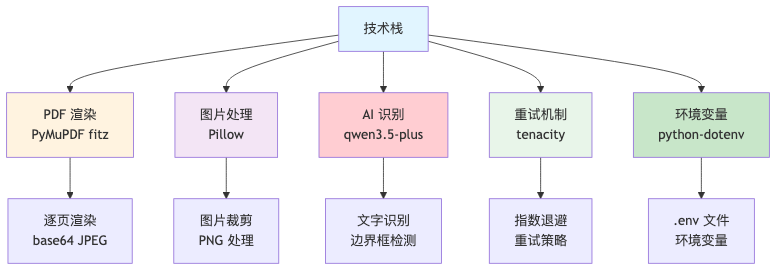
核心技术
PDF 渲染:
- PyMuPDF (fitz)
- 逐页渲染
- base64 JPEG 编码
图片处理:
- Pillow
- 图片裁剪
- PNG 处理
AI 识别:
- 阿里云 DashScope qwen3.5-plus
- OpenAI 兼容协议
- hybrid thinking 模型
重试机制:
- tenacity
- 指数退避
- 稳定可靠
环境变量:
- python-dotenv
- .env 文件支持
- 环境变量管理
八、项目结构
项目目录结构
Paper2MD/
├── .claude/
│ ├── agents/
│ │ └── paper2md.md # Agent 定义 + 工作流(自然语言触发)
│ └── skills/
│ ├── pdf2md/ # Skill 1: PDF → 文字 Markdown + 图片嵌入
│ │ ├── SKILL.md
│ │ └── scripts/
│ │ ├── convert.py # PDF 页面 → Markdown 文字
│ │ ├── embed_figures.py # 图片引用嵌入后处理
│ │ └── prompt.md # VLM system prompt(qwen3.5-plus 用)
│ └── pdf-extract-figures/ # Skill 2: 提取 Figure/Table
│ ├── SKILL.md
│ └── scripts/
│ └── extract_figures.py
├── PDFs/ # 输入 PDF
├── output/ # 所有输出
├── CLAUDE.md # Claude Code 项目指令(Claude 自动读取)
├── README.md
└── requirements.txt
核心文件
Agent 定义:
.claude/agents/paper2md.md- 自然语言触发
- 完整流水线
Skill 1:
.claude/skills/pdf2md/SKILL.md- PDF → Markdown 文字
- 图片嵌入后处理
Skill 2:
.claude/skills/pdf-extract-figures/SKILL.md- 提取 Figure 为 PNG
- 支持仅提取 Figure 模式
九、注意事项
注意事项
API Key:
- 需要阿里云 DashScope API Key
- 获取地址:https://dashscope.console.aliyun.com/
图表提取耗时:
- 每张图约 1-3 次 VLM 调用
- 10-20 张图约需 5-15 分钟
qwen3.5-plus:
- hybrid thinking 模型
- 仅采用 content 字段
- 忽略 reasoning_content
Windows:
- 使用 conda run --no-capture-output
- 避免 GBK 编码问题
.env 文件:
- 已在 .gitignore 排除
- 请勿提交
十、实际应用场景
场景 1:学术论文阅读
需求:阅读学术论文,做笔记
使用 Paper2MD:
- 将 PDF 转换为 Markdown
- 复制到笔记软件
- 添加个人注释
- 便于检索和分享
价值:
- 易于复制粘贴
- 保留公式和图表
- 便于笔记管理
场景 2:文献综述
需求:整理多篇论文,做文献综述
使用 Paper2MD:
- 批量转换多篇论文
- 统一格式
- 对比分析
- 生成综述
价值:
- 统一格式
- 便于对比
- 提高效率
场景 3:技术博客
需求:基于论文写技术博客
使用 Paper2MD:
- 转换论文为 Markdown
- 提取核心内容
- 添加个人理解
- 发布博客
价值:
- 保留原始内容
- 便于二次创作
- 提高写作效率
场景 4:知识库构建
需求:构建个人知识库
使用 Paper2MD:
- 转换论文为 Markdown
- 存入知识库
- 标签管理
- 全文检索
价值:
- 结构化存储
- 便于检索
- 知识管理
十一、核心价值
1. 完整还原
文字内容:
- 完整识别所有文字
- 保留段落结构
- 支持双栏布局
LaTeX 公式:
- 自动识别数学公式
- 转换为 LaTeX 格式
- 保持公式结构
表格:
- Table 由 VLM 转为 Markdown 文本
- 保留表格结构
- 支持复杂表格
2. 智能图表处理
Table 处理:
- 由 VLM 转为 Markdown 文本
- 避免重复提取
- 保持可读性
Figure 处理:
- 提取为 PNG 图片
- 高精度裁剪
- 嵌入到 Markdown
3. 高精度定位
多轮质量评估:
- 第一轮:粗定位
- 第二轮:精确边界
- 第三轮:质量验证
精确裁剪:
- 边界框坐标
- PNG 裁剪
- 去除空白
4. 整洁输出
独立子目录:
- 每篇论文独立目录
- 互不干扰
- 便于管理
结构化输出:
- Markdown 文件
- figures 目录
- manifest.json
5. Claude Code 集成
自然语言驱动:
- 简单直观
- 无需命令
- AI 辅助
完整流水线:
- 1 个 agent
- 2 个 skills
- 自动化处理
十二、总结
核心问题
学术论文 PDF 转换的痛点:
- PDF 难以复制粘贴
- 公式、表格、图表无法正确转换
- 手动转换耗时耗力
- 输出格式不统一
Paper2MD 的解决方案
1. 完整还原
- 文字内容(含 LaTeX 公式、表格、双栏布局)
- 所有 Figure 截图
- 视觉效果一致
2. 智能图表处理
- Table 由 VLM 转为 Markdown 文本
- Figure 提取为 PNG 图片嵌入
- 避免重复
3. 高精度图表定位
- Qwen3.5-plus VLM 多轮质量评估
- 精确裁剪图表边界
- 无多余空白
4. 占位符清理
- 自动移除 VLM 生成的图表占位符
- 消除重复 Caption
- 整洁输出
5. 整洁输出
- 每篇论文独立子目录
- 互不干扰
- 结构化输出
6. Claude Code 集成
- 1 个 agent + 2 个 skills
- 自然语言驱动完整流水线
- 简单直观
为什么选择 Paper2MD?
1. 完整还原
- 文字内容完整
- 公式、表格、图表保留
- 视觉效果一致
2. 智能处理
- Table 转为 Markdown
- Figure 提取为 PNG
- 避免重复
3. 高精度定位
- 多轮质量评估
- 精确裁剪边界
- 高质量输出
4. 整洁输出
- 独立子目录
- 结构化输出
- 便于管理
5. 自然语言驱动
- Claude Code 集成
- 简单直观
- AI 辅助
记住
Paper2MD 是一个 Claude Code 项目,将学术 PDF 论文转换为带图表嵌入的完整 Markdown。
无本地 GPU 依赖,全程 API 驱动,输出效果与原始 PDF 视觉一致。
完整还原 + 智能图表处理 + 高精度定位 + 整洁输出 + Claude Code 集成。
附:资源链接
项目资源:
- GitHub:https://github.com/Deng-GuiFeng/Paper2MD
- License:MIT
快速开始:
# 环境配置
conda create -n paper2md python=3.11 -y
conda activate paper2md
pip install -r requirements.txt

# 配置 API Key
echo 'DASHSCOPE_API_KEY=your-api-key' > .env

# 使用
用 paper2md 处理 PDFs/paper.pdf技术栈:
- PDF 渲染:PyMuPDF (fitz)
- 图片处理:Pillow
- AI 识别:阿里云 DashScope qwen3.5-plus
- 重试机制:tenacity
- 环境变量:python-dotenv