
手头一堆扫描版 PDF 技术书?趁 GLM 夜间免费,睡一觉转成 EPUB
先说一个很多人没刷到的消息:
GLM Coding Plan「夜间畅用」活动,9 月 3 日–20 日,每晚 23:00 到次日 09:00——GLM-5.3-Flash 在 ZCode 里额度消耗为 0,走其他 Agent 额度也翻倍。 不用报名,进时段自动生效。
看到这条的时候我愣了一下。
因为我上周刚写完一个工具 pdf2epub-glmflash,它从第一行代码到转完最后一页,唯一用的模型就是 GLM-5.3-Flash。这场活动,像专门为它开的窗口。
▍你是不是也有这样一堆 PDF
晚高峰地铁上,你单手举着手机,看一份 419 页的扫描版《Debug Hacks》。
一整页 A4 扫描图,字小得像蚂蚁。两指捏开放大,看三行,往右拖,再看三行,再拖回来——代码被扫成了图片,想复制出来搜一下都做不到。 " 那本"想读很久"的书,就这样在手机里躺了半年。
不是你不想读,是没有人能用这种方式读完一本技术书。
▍这个工具做了什么
把扫描 PDF 每页渲染成图,交给 GLM-5.3-Flash 逐页转录成 Markdown,再组装成一本真正的 EPUB。
419 页,8 分钟。
转出来的书长这样:
正文是流动排版的真文字,字号随你调;GDB 调试会话躺在灰底等宽代码块里,缩进原样保留;书里的流程图按 300 dpi 从 PDF 裁出来,嵌在它原本所在的段落之间——和纸质书一个位置。
728 个代码块、25 张表格,一个没丢。
这些数字不是我的感觉,是逐项验证过的:每本书抽样 5 页,用独立提示词让模型重新转录一遍,两份逐字对比,正文页相似度 97%–99.6%;章节切分位置用"印刷页码与 PDF 页码偏移恒定 +18"校验过;每个 EPUB 都通过了严格 XML 解析——你不会在阅读器里看到莫名报错。
▍为什么传统 OCR 做不到
我试过:代码块读成断行乱码,表格拆成碎片,插图直接消失。因为它们识别的是字符,不理解版式。
GLM-5.3-Flash 是原生多模态模型,它是"看着整页"工作的:代码进围栏块、表格画成 Markdown、页眉页脚和水印自动丢弃,连盗版库的生成页都整页清掉。
2-up 双联页扫描(《海盗派测试分析》)、双栏排版(《自动化测试最佳实践》这种)也有写死的阅读顺序规则,不会把句子读串。
▍🌙 睡后工作流:这才是活动的正确打开方式
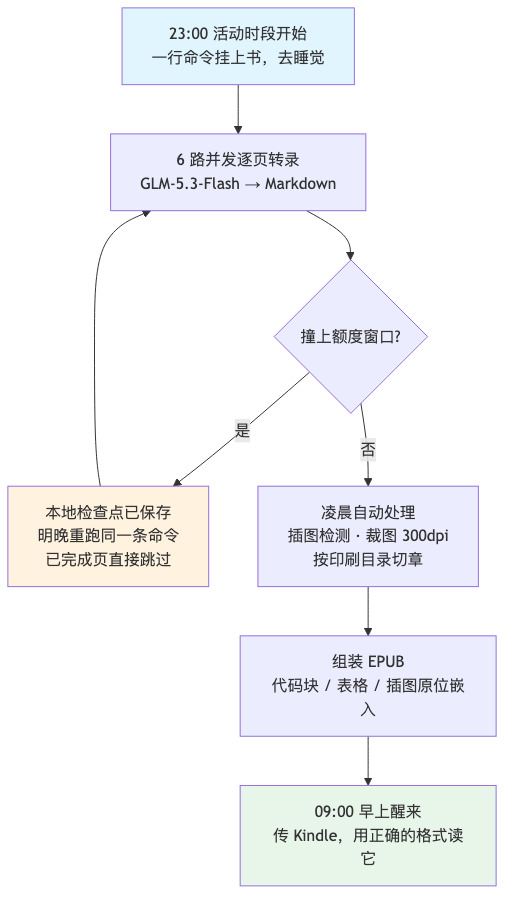
把工具和活动拼起来,就是一套"睡后工作流"(见上面的流程图):
23:00,活动时段开始,敲一行命令挂上书,你去睡觉。工具 6 路并发转录,凌晨自动做插图检测、裁图、按印刷目录切章。
中间就算撞上额度窗口也不慌——每页都有本地检查点,明晚 23:00 重跑同一条命令,已完成的页直接跳过,一分额度不重花。(我转《渗透测试实践指南》时真撞上过限额,恢复后续传,一页没重花。)
早上 09:00 醒来,传到 Kindle 里的,是一本排版干净、章节齐全、插图在位的 EPUB。
阅读这件事本来就属于早上地铁和周末午后——让 GPU 值夜班,你值白班。
▍账帮你算好了
活动期内,夜间时段 GLM-5.3-Flash 额度减免/加成,跑书的边际成本趋近于零——一杯奶茶钱都不用,花的是你本来就在睡觉的时间。
工具会自动发现本机 ZCode 配置里的密钥,连环境变量都可以不配。规则提醒:免额度仅限 ZCode 渠道(其他 Agent 是×2)、仅限 GLM-5.3-Flash、注意每周 5 小时限额刷新,细节以官方页面为准。
▍完整源码,免费领
这个项目我没有设任何门槛:
- 完整源码(Python,单文件,MIT 协议)
- 一份从零开始的部署教程(含我踩过的坑)
- 「夜间挂机」专用配置建议
添加我的微信 RichSec2025,备注"电子书",免费领取。
也欢迎进读者群——你转自己书的时候遇到格式刁钻的(双栏、竖排、日文原版),发出来我们一起调。
最后提醒一句:活动 9 月 20 日截止,从今晚算起只剩 6 个夜晚。 别贪多,一晚清一两本就够了。
那本在手机里躺了半年的扫描书,你已经拥有它了,只是它一直卡在错误的格式里。今晚睡前挂上,明天早上,用正确的格式读它。
(工具仅用于转换你自己拥有的书籍副本,供个人阅读。)