
Semantica:为 AI Agent 构建可审计的知识图谱
"
前言:AI 的"黑箱"困境
2026-08-12 14:53 GMT+8
大多数 AI Agent 在"暗箱"中运行。
它们存储的是嵌入(embeddings),而不是意义(meaning):
- ✅ 上下文可以检索("什么相似?")
- ❌ 上下文无法解释("为什么相关?")
- ❌ 决策无法审计("为什么做这个决定?")
在高风险领域,这是个问题:
- 金融:贷款审批必须通过监管机构的"为什么"询问
- 医疗:诊断决策必须有完整的因果链
- 法律:案件分析必须有可追溯的证据链
- 政府:政策决策必须有完整的决策路径
今天介绍 Semantica:
Graph-Native Infrastructure for Context and Accountable AI Systems
开源版 Palantir for AI Agents
一、项目概览
Semantica 是一个开源的、基于图的知识图谱基础设施,为 AI Agent 提供可审计、可解释、可追溯的上下文管理。
一句话说清楚:
摄取企业数据,提取关键信息,构建上下文图谱和知识图谱,运行图分析和因果推理,所有决策都带有完整的可追溯性。
项目地址:https://github.com/semantica-agi/semantica 官网:https://getsemantica.ai 文档:https://docs.getsemantica.ai 开源协议:MIT Python:3.8+
核心特性
决策智能(Decision Intelligence)
- 上下文管理(Context Management)
- 确定性推理(Deterministic Reasoning)
- 本体管理(Ontology Management)
- 知识建模(Knowledge Modeling)
- 端到端可追溯性(End-to-End Traceability)
企业级特性
- 开源、可自托管、可审计、可治理、零供应商锁定
- 多语言图存储(RDF & LPG 支持)
- W3C 标准兼容、可互操作
目标用户
1. AI/ML 平台团队
- 部署 Agent 做关键决策
- 需要结构化、可查询的上下文
- 不只是向量索引
2. Databricks/Snowflake 数据平台团队
- 需要把表变成知识图谱
- 不需要先导出到第三方 SaaS
3. 合规、风险、审计团队
- 需要"为什么 AI 做了这个决定?"的直接答案
- 格式必须被监管机构接受
4. 受监管企业
- 金融、医疗、法律、政府、国防
- 不能部署黑箱
- 不能把数据发送给第三方 SaaS
5. 平台和基础设施工程师
- 需要 KG、推理、provenance 栈可自托管、可替换
- 不锁定于单一供应商
6. 数据和知识工程师
- 从混乱、多源数据构建 KG
- 实体和关系提取、冲突检测、重复合并
二、核心能力
1. Context Graphs:上下文图谱
定义:
- 一个结构化的、可查询的图
- 包含 Agent 知道的、决定的、推理的所有内容
对比传统 RAG:
- RAG:回答"什么相似?"(嵌入相似度)
- Context Graph:回答"什么相连、为什么、如何?"(图遍历)
核心能力:
- ✅ 每个实体、关系、决策、事实都是一等节点
- ✅ 可通过图遍历查询
- ✅ 实体链接到源文档
- ✅ 决策链接到证据和后果
- ✅ 事实携带完整 provenance
- ✅ 冲突被检测,而非静默覆盖
为什么图优于嵌入?
- 遍历找到嵌入错过的连接(距合同 3 跳的人)
- 每个节点携带 provenance
- 冲突在污染知识库之前被标记
- 时间点快照允许重放历史而无需重新处理
2. Decision Intelligence:决策智能
定义:
- 每个 AI 决策都是一等对象
- 可追溯、可按先例搜索、因果链接
核心问题:
"你的 AI 决定了什么、为什么、接下来发生了什么?"
这是监管机构和企业风险团队越来越迫切询问的问题。
在 Semantica 中,决策不是日志行:
- 它是一个完整生命周期的图节点
- 存储为带有完整结构上下文的图节点
- 可导出为 W3C PROV-O(大多数合规框架接受的监管提交格式)
核心 API:
record_decision()             # 存储为带有完整结构上下文的图节点
add_causal_relationship()     # 链接到上游原因和下游效果
find_similar_decisions()      # 跨所有过去决策的语义先例搜索
trace_decision_chain()        # 完整因果谱系回到根本原因
analyze_decision_impact()     # 下游影响图 - 此决策影响的一切
check_decision_rules()        # 策略合规门
export / audit trail          # W3C PROV-O, CSV, 或 JSON 用于监管提交
3. AI Governance & Ontology:AI 治理和本体
核心能力:
- SHACL 约束:Shapes 约束语言
- 冲突检测:冲突事实被标记和解决
- 合规规则:内置规则引擎
- OWL 生成:Web 本体语言
- SKOS 词汇表管理:知识组织系统
- 可视化编辑器:交互式本体管理
4. Full Auditability:完全可审计性
核心能力:
- W3C PROV-O provenance:每个事实
- 审计追踪:可导出为 JSON, CSV, 或 RDF
- 时间旅行:时间点图快照
- 因果链:完整的决策谱系
5. Deterministic Reasoning:确定性推理
推理引擎:
- Forward chaining:前向链推理
- Rete network:Rete 网络算法
- Datalog:数据日志语言
- SPARQL:SPARQL 查询语言
特点:
- ✅ 完全可解释的路径
- ✅ 不是黑箱
- ✅ 不需要 LLM
6. Knowledge Pipeline:知识管道
核心能力:
- 多源摄取:文件、Web、数据库、企业数据平台、云、流、Git、邮件、MCP
- 实体感知分块:GraphRAG 原生
- NER/关系/事件提取:命名实体识别、关系提取、事件提取
- 知识图谱构建:自动构建 KG
- 语义去重:智能重复合并
- Provenance 保留合并:追溯保留
7. Enterprise Data Platforms:企业数据平台
原生连接器:
Databricks:
- Unity Catalog + Delta Lake
- PAT/OAuth M2M 认证
- catalog/schema/table/lineage 内省
Snowflake:
- warehouse/database/schema
- 密钥对和 OAuth 认证
价值:
- ✅ 已经居住在你的湖屋或仓库中的表变成带有 provenance 的图节点
- ✅ 不是另一个导出/导入跳
8. Graph Analytics:图分析
核心能力:
- 中心性:节点重要性分析
- 社区检测:群体发现
- 链路预测:关系预测
- 最短路径查询:路径优化
9. Polyglot Graph Storage:多语言图存储
RDF 存储:
- 嵌入式 Oxigraph
- Blazegraph
- Apache Jena
- Eclipse RDF4J(通过 SPARQL)
LPG 存储:
- Neo4j
- FalkorDB
- Apache AGE
- AWS Neptune(通过 Cypher)
向量存储:
- FAISS
- 其他向量存储
特点:
- ✅ 所有都可交换
- ✅ 无需触摸代码
10. Visualization:可视化
核心能力:
- 交互式浏览器工作台
- 探索任何图、本体或时间线
- Knowledge Explorer
- Ontology Hub
11. Drop-in Integrations:即插即用集成
原生支持:
- Agentic:原生支持
- MCP 服务器:完整的 MCP 服务器
- CLI:全面的 CLI
- REST API:RESTful API
- 编辑器插件:跨主要编辑器的插件
三、对比分析
Semantica vs Vector DB + RAG
| 维度 | Vector DB + RAG | Semantica |
|---|---|---|
| 召回方法 | 嵌入相似度 | 图遍历 + 语义搜索 |
| 决策历史 | 不存储 | 不存储 → 一等可查询对象 |
| Provenance | 无 | 无 → W3C PROV-O, 源链接 |
| 推理 | 无 | 无 → 前向链, Rete, Datalog, SPARQL |
| 冲突检测 | 静默覆盖 | 静默覆盖 → 检测、标记、解决 |
| 时间旅行 | 无 | 无 → 时间点图快照 |
| 合规导出 | 无 | 无 → PROV-O, SHACL, OWL, RDF |
| 策略执行 | 无 | 无 → 内置规则引擎 + SHACL |
| 实体解析 | 无 | 无 → Blocking + 语义去重 |
| 多 Agent 上下文 | 每个 Agent 分离 | 每个 Agent 分离 → 单一共享智能层 |
核心差异:
- Semantica 补充你的现有栈,而不是替换它
- 保持你的 LLM、向量存储、Agent 框架完全不变
- Semantica 添加决策记录、因果推理、provenance、本体治理、冲突检测、审计追踪
Semantica vs Plain LLM Memory
| 维度 | Plain LLM Memory | Semantica |
|---|---|---|
| 召回方法 | Token 窗口 | 图遍历 + 语义搜索 |
| 决策历史 | 不存储 | 一等可查询对象 |
| Provenance | 无 | W3C PROV-O, 源链接 |
| 推理 | 黑箱 | 前向链, Rete, Datalog, SPARQL |
| 冲突检测 | 静默覆盖 | 检测、标记、解决 |
| 时间旅行 | 无 | 时间点图快照 |
| 合规导出 | 无 | PROV-O, SHACL, OWL, RDF |
| 策略执行 | 无 | 内置规则引擎 + SHACL |
| 实体解析 | 无 | Blocking + 语义去重 |
| 多 Agent 上下文 | 每个 Agent 分离 | 单一共享智能层 |
核心差异:
- LLM Memory 是黑箱
- Semantica 是白箱、可解释、可审计
四、快速开始
安装
pip install semantica验证安装
semantica doctor

# Python 3.11.9         pass
# semantica 0.6.5       pass
# faiss vector store    pass
# Config file           pass    ~/.semantica/config.yaml
Decision Intelligence 示例
from semantica.context import ContextGraph

graph = ContextGraph(advanced_analytics=True)

# 每个 Agent 决策变成可查询、可审计的知识节点
decision_id = graph.record_decision(
    category="vendor_selection",
    scenario="Choose cloud provider for HIPAA workload",
    reasoning="AWS offers BAA, mature HIPAA tooling, and existing team expertise",
    outcome="selected_aws",
    confidence=0.93,
)

# 问"为什么发生这个?"并获得一个真实的、结构化的答案
chain     = graph.trace_decision_chain(decision_id)       # 完整因果谱系
similar   = graph.find_similar_decisions("cloud vendor", max_results=5)  # 先例
impact    = graph.analyze_decision_impact(decision_id)    # 下游影响图
compliant = graph.check_decision_rules({"category": "vendor_selection"})  # 策略门
Context Graph 示例
from semantica.context import ContextGraph, AgentContext
from semantica.vector_store import VectorStore

graph = ContextGraph(advanced_analytics=True)

# 添加带有类型属性的节点
graph.add_node("acme_corp",    "Organization", name="Acme Corp", industry="SaaS")
graph.add_node("alice_chen",   "Person",       name="Alice Chen", role="CTO")
graph.add_node("contract_001", "Contract",     value=2_400_000, currency="USD")

# 添加类型化、加权边
graph.add_edge("alice_chen", "acme_corp",    edge_type="works_for",  since="2019-03-01")
graph.add_edge("acme_corp",  "contract_001", edge_type="party_to",   signed="2024-01-15")

# BFS 遍历 - 从任何节点跳过图
neighbors = graph.get_neighbors("acme_corp", hops=2)

# 时间点快照 - 过去任何日期的图状态
snapshot  = graph.state_at("2024-01-01")
五、实际场景
场景 1:审计追踪(金融)
场景:贷款审批决策
需求:
- 监管机构要求回答"为什么批准这笔贷款?"
- 必须提供完整的因果链
- 必须可以追溯到源数据
使用 Semantica:
from semantica.context import ContextGraph
from semantica.provenance import ProvenanceManager
from semantica.export import RDFExporter

graph = ContextGraph(advanced_analytics=True)
prov  = ProvenanceManager(storage_path="./audit.db")

# 记录决策链
d1 = graph.record_decision(
    category="credit_application",
    scenario="Personal loan, $85k income, 31% DTI, 3yr employment",
    reasoning="Income meets threshold; employment stable; no adverse credit events",
    outcome="proceed_to_underwriting",
    confidence=0.88,
    metadata={"applicant_id": "A-7291"},
)

d2 = graph.record_decision(
    category="loan_underwriting",
    scenario="Underwriting review for A-7291",
    reasoning="DTI within policy; clean 36-month credit history",
    outcome="approved",
    confidence=0.94,
)

# 建立因果链
graph.add_causal_relationship(d1, d2, relationship_type="CAUSED")

# 追踪每个实体的 provenance
prov.track_entity("applicant_A7291", source="loan_applications_2024.json")

# 导出 W3C PROV-O 用于监管提交
graph_dict = graph.to_dict()
kg = {
    "entities": [{"id": n["id"], "type": n["type"], "text": n["content"]} for n in graph_dict["nodes"]],
    "relationships": [
        {"source_id": e["source"], "target_id": e["target"], "type": e["type"]}
        for e in graph_dict["edges"]
    ],
}
RDFExporter().export(kg, "audit_trail.ttl", format="turtle")价值:
- ✅ 完整的因果链
- ✅ 可追溯到源数据
- ✅ W3C PROV-O 格式
- ✅ 监管机构接受
场景 2:医疗决策(医疗)
场景:药物相互作用检查
需求:
- 检测药物相互作用
- 记录决策和原因
- 提供完整的审计追踪
使用 Semantica:
from semantica.context import ContextGraph

graph = ContextGraph(advanced_analytics=True)

# 记录决策链
d1 = graph.record_decision(
    category="drug_interaction_check",
    scenario="Patient P-4821: warfarin + amiodarone co-prescribed",
    reasoning="Amiodarone potentiates warfarin's anticoagulant effect",
    outcome="flag_for_review",
    confidence=0.91,
)

d2 = graph.record_decision(
    category="dosage_adjustment",
    scenario="INR monitoring plan for P-4821",
    reasoning="Reduce warfarin dose per interaction severity; recheck INR in 5 days",
    outcome="dose_reduced_30pct",
    confidence=0.87,
)

# 建立因果链
graph.add_causal_relationship(d1, d2, relationship_type="CAUSED")

# 查询决策链
chain = graph.trace_decision_chain(d2)价值:
- ✅ 完整的决策链
- ✅ 可解释的推理
- ✅ 可审计的追踪
场景 3:企业数据平台(Databricks/Snowflake)
场景:从 Databricks 表构建知识图谱
需求:
- 把 Unity Catalog 中的表变成知识图谱
- 不需要导出到第三方 SaaS
- 保留 provenance
使用 Semantica:
from semantica.ingest import DatabricksIngestor

# 连接到 Databricks
ingestor = DatabricksIngestor(
    host="adb-123456789.1.azuredatabricks.net",
    token="your_token",
    catalog="production",
)

# 摄取表并构建知识图谱
graph = ingestor.ingest_table("customers", "sales", "customer_orders")

# 表变成带有 provenance 的图节点
# 每个节点都知道它来自哪个表、哪个模式、哪个 catalog价值:
- ✅ 无需导出数据
- ✅ 保留 provenance
- ✅ 可查询的图结构
场景 4:多 Agent 上下文共享
场景:多个 Agent 需要共享上下文
需求:
- Agent A 做了决策
- Agent B 需要知道这个决策
- Agent C 需要追踪影响
使用 Semantica:
from semantica.context import AgentContext

# 创建共享的上下文
ctx = AgentContext()

# Agent A 记录决策
agent_a_decision = graph.record_decision(
    category="vendor_selection",
    scenario="Choose cloud provider",
    outcome="selected_aws",
)

# Agent B 查询决策
similar = graph.find_similar_decisions("cloud vendor")

# Agent C 分析影响
impact = graph.analyze_decision_impact(agent_a_decision)价值:
- ✅ 单一共享智能层
- ✅ 所有 Agent 可以访问
- ✅ 完整的因果链
六、架构设计
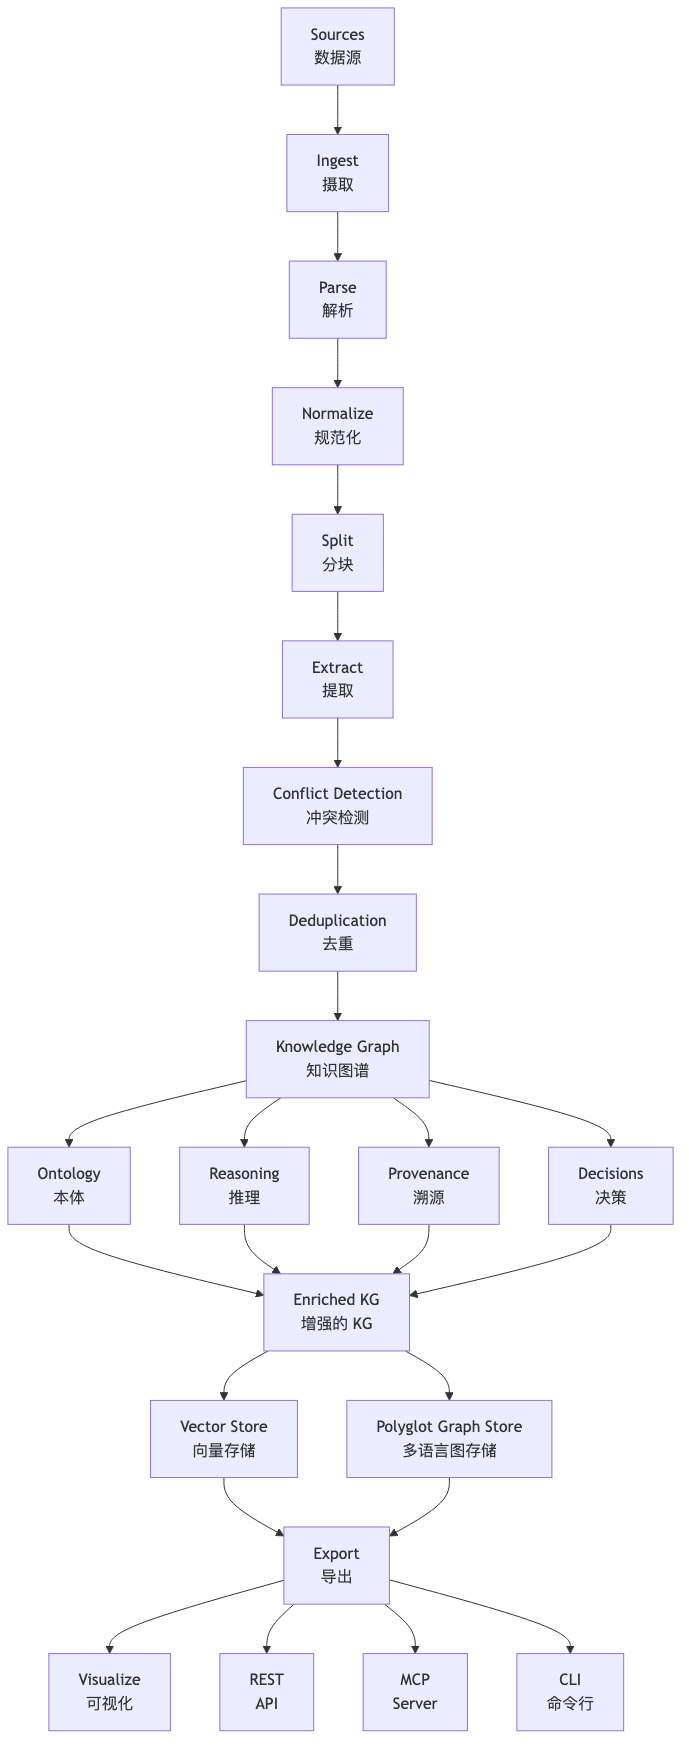
端到端管道
Semantica 是一个真正的端到端管道,不是单个库:
Sources → Ingest → Parse → Normalize → Split → Extract → Conflict Detection → Deduplication
   → Knowledge Graph → [ Ontology · Reasoning · Provenance · Decisions ] → Enriched KG
   → Vector Store + Polyglot Graph Store (RDF & LPG) → Export / Visualize / REST · MCP · CLI
每个阶段都是可独立导入的模块
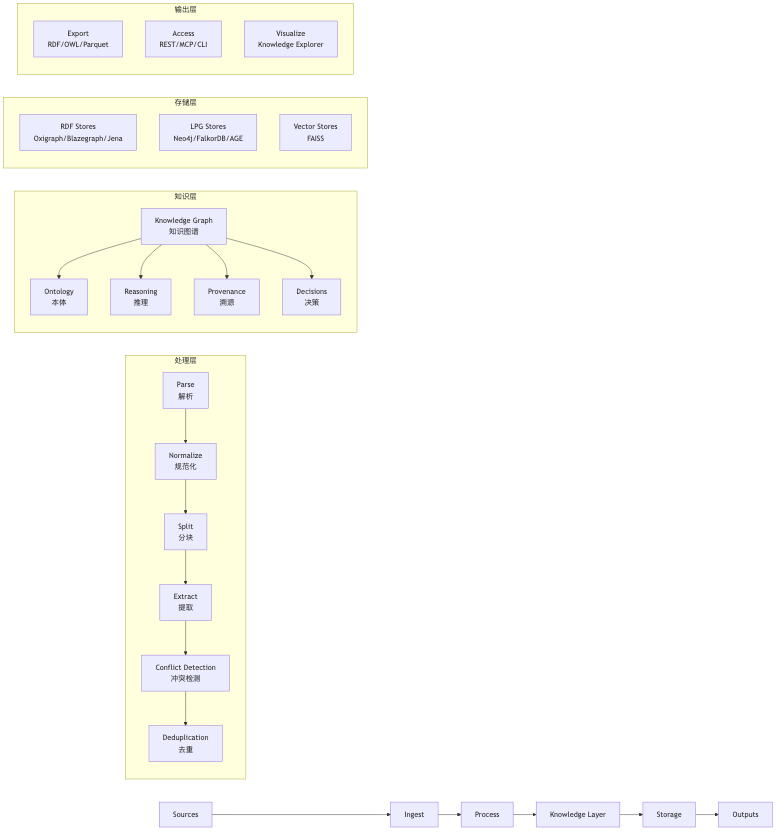
摄取层
数据源:
- 文件、Web、数据库
- 企业数据平台(Databricks, Snowflake)
- 云(Google Drive, Elasticsearch)
- 流(Kafka, Kinesis)
- Git, 邮件, MCP
处理层
Parse → Normalize → Split:
- 文档解析
- 文本/实体/日期规范化
- GraphRAG 原生实体感知分块
Extract → Conflict Detection → Deduplication:
- NER, 关系, 事件, 三元组
- 冲突事实在合并前被标记和解决
知识层
Knowledge Graph:
- GraphBuilder 构建图
- 双时态事实
- 完整图分析(中心性、社区、链路预测)
Ontology · Reasoning · Provenance · Decisions:
- SHACL/OWL 治理
- Rete/Datalog/SPARQL 推理
- W3C PROV-O lineage
- 一等决策记录
存储层
Polyglot by Design:
- RDF 三重存储(嵌入式 Oxigraph, Blazegraph, Apache Jena, Eclipse RDF4J)
- 标记属性图(Neo4j, FalkorDB, Apache AGE, AWS Neptune)
- 向量存储(FAISS)
- 所有都可交换无需触摸代码
输出层
Export:
- RDF, OWL, Parquet, Cypher, JSON-LD
Access:
- REST API
- MCP 服务器
- CLI
Visualization:
- 交互式可视化
- Knowledge Explorer
- Ontology Hub
七、核心价值
1. 可审计性
完整审计追踪:
- W3C PROV-O provenance
- 时间点快照
- 决策因果链
- 源数据追溯
合规导出:
- W3C PROV-O, SHACL, OWL, RDF
- 监管机构接受的格式
2. 可解释性
确定性推理:
- 前向链、Rete 网络、Datalog、SPARQL
- 完全可解释的路径
- 不是黑箱
冲突检测:
- 冲突事实被标记
- 在污染知识库之前解决
- 而非静默覆盖
3. 可追溯性
Provenance 追踪:
- 每个实体都有源链接
- 每个决策都有因果链
- 每个事实都有时间戳
时间旅行:
- 时间点图快照
- 重放历史而无需重新处理
4. 企业级特性
自托管:
- 完全自托管
- 无需第三方 SaaS
- 零供应商锁定
多语言图存储:
- RDF 和 LPG 支持
- 所有存储都可交换
- 无需更改代码
W3C 标准:
- PROV-O, SHACL, OWL, SKOS
- 可互操作
- 开放标准
八、总结
核心问题
大多数 AI Agent 在"暗箱"中运行:
- ❌ 存储嵌入,而不是意义
- ❌ 上下文可以检索,但无法解释
- ❌ 决策无法审计
Semantica 的解决方案
Graph-Native Infrastructure:
- ✅ 结构化、可查询的上下文图谱
- ✅ 每个决策都是一等对象
- ✅ 完整的 provenance 追踪
- ✅ 确定性推理引擎
三大核心价值
1. 决策智能
- 每个决策都是一等对象
- 可追溯、可查询、因果链接
- 语义先例搜索
2. 上下文图谱
- 结构化、可查询的图
- 实体、关系、决策、事实都是节点
- 冲突检测、时间旅行
3. 完全可审计性
- W3C PROV-O provenance
- 监管机构接受的格式
- 完整的因果链
为什么选择 Semantica?
1. 不是替换,是补充
- 保持你的 LLM、向量存储、Agent 框架
- Semantica 添加决策记录、provenance、审计追踪
2. 开源、自托管
- 零供应商锁定
- 完全控制
- 企业级特性
3. W3C 标准
- 可互操作
- 开放标准
- 监管机构接受
适用领域
高风险、受监管领域:
- ✅ 金融(贷款审批、风险控制)
- ✅ 医疗(诊断决策、药物相互作用)
- ✅ 法律(案件分析、合同审查)
- ✅ 政府(政策决策、合规检查)
- ✅ 国防(情报分析、威胁评估)
记住
Semantica 不是另一个 RAG 工具,而是为 AI Agent 构建的、可审计的知识图谱基础设施。
从"嵌入"到"意义",从"黑箱"到"白箱",从"不可审计"到"完全可追溯"。
这不是优化,这是范式转变。
附:资源链接
项目资源:
- GitHub:https://github.com/semantica-agi/semantica
- 官网:https://getsemantica.ai
- 文档:https://docs.getsemantica.ai
- Discord:https://discord.gg/sV34vps5hH
学习资源:
- YouTube 演示:https://www.youtube.com/watch?v=QfnNZg4-dZA
- 架构文档:ARCHITANGCE.md
- Changelog:CHANGELOG.md
- PyPI:https://pypi.org/project/semantica/
安装速查:
# 安装
pip install semantica

# 验证
semantica doctor

# 快速开始
python -c "from semantica.context import ContextGraph; graph = ContextGraph()"