
GitHub 官方出手:Spec Kit 把"写文档"变成"写可执行的规格
前言
AI 编程最大的坑,不是代码写得烂,是方向写错。 " 你跟 Agent 说"做个照片管理应用",它"唰"一下给你生成一堆代码。跑起来一看——相册要按日期分组、能拖拽重排、不能嵌套——它一个都没做对。不是它不会,是你没说清。
GitHub 官方的开源项目 Spec Kit,给这个问题一个工程化答案:先定义要建什么,再动手建。规格不再是代码前的脚手架,而是直接驱动实现的"可执行规格"。
一句话说清楚:
规格驱动开发(SDD)——spec 变成可执行的,直接生成实现,而不是仅仅"指导"实现。
- GitHub:https://github.com/github/spec-kit
- 文档:https://github.github.io/spec-kit
- GitHub 官方出品,一周年时发布 1.0.0,MIT 协议
一、项目身份
Spec Kit 是 GitHub 官方出的 AI 编码代理工具包,核心是规格驱动开发(Spec-Driven Development, SDD)的完整流程。
传统开发里,代码是王,规格是搭完就扔的脚手架。SDD 把这个关系倒过来:规格成了源头产物,代码从规格里长出来。这对 AI 编程时代尤其重要——Agent 生成代码很便宜,但生成"错误的代码"更便宜,唯一能约束它的就是一份写清楚了的规格。
维护者在一周年博客里有句挺有意思的话:1.0.0 现在只是个数字。当 Agent 让"适应变化"变得极其便宜,价值就从"稳定"转移到了"可适应性"。这话本身就是 SDD 世界观的注脚。
另外它自吃狗粮:README 里有专门一节"Spec Kit 用不用 Spec Kit"——自己开发的规格自己管。
二、主执行链路
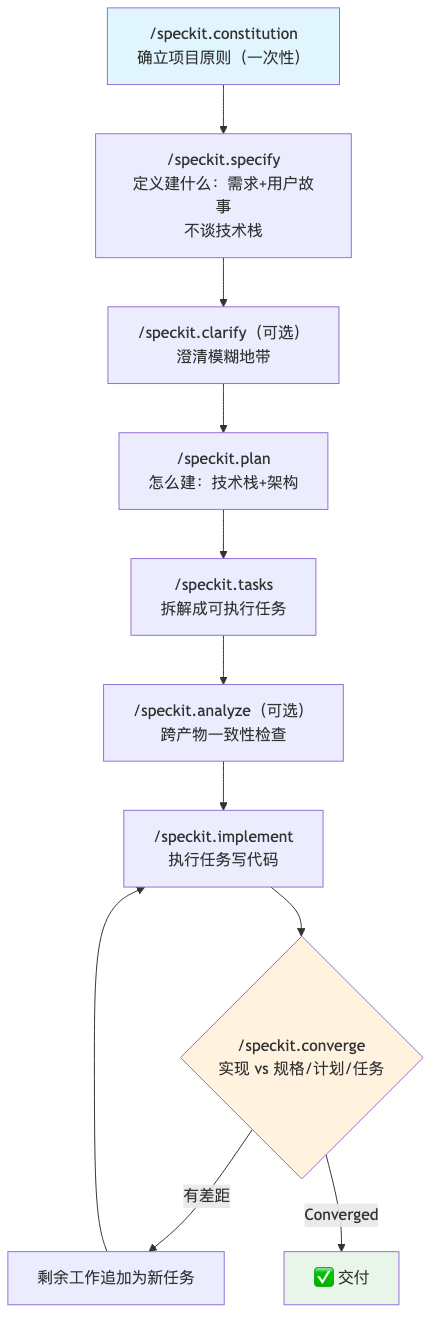
六个核心命令,一个循环:
/speckit.constitution(一次性):立项目宪法——代码质量、测试标准、性能要求这些"不该每次重新讨论"的原则/speckit.specify:写需求,只说 what 和 why,不碰技术栈/speckit.plan:这时候才谈 how——用什么栈、什么架构/speckit.tasks:计划拆成任务清单(还能/speckit.taskstoissues直接转 GitHub Issues)/speckit.implement:Agent 执行任务/speckit.converge:拿实现和规格、计划、任务对账,差距追加为新任务,回到第 5 步——直到报告 Converged
最后这个 converge 循环是关键。它承认了一个现实:Agent 一次实现不可能完全贴合规格。与其假装能一次到位,不如把"对齐"做成显式的、可重复的循环步骤。这和 TDD 的红-绿-重构是一个思路,只是对齐的对象从测试换成了规格。
三个可选命令补质量:clarify 在计划前把模糊需求问清,analyze 在实现前做跨产物一致性分析,checklist 生成需求质量检查清单——官方管它叫 "unit tests for English",给英语写单元测试。这个比喻值得记住。
三、核心模块与架构
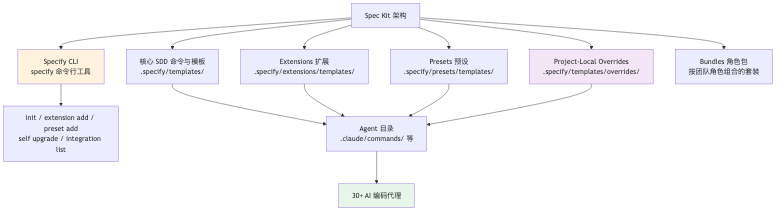
CLI 是壳,模板是肉。specify init 把命令文件写进各 Agent 的目录(比如 .claude/commands/),之后你在 Agent 里用斜杠命令驱动整个流程。
四层优先级栈是模板系统的精髓,运行时自顶向下找第一个命中的:
- 项目本地覆盖(最高):单个项目的一次性调整,不用建完整预设
- Presets:改"怎么做"——合规格式的 spec、领域术语、组织标准,可叠加、按优先级排序,移除时自动恢复下一层
- Extensions:加"能做什么"——新命令、新阶段、外部工具集成
- 核心默认:兜底
Bundles 是按角色打包的套装——架构师、开发者、评审各装各的组合。
四、两条延伸工作流
除了主链路,还有两个可选扩展,各管一个高频痛点:
Bug 修复(assess → fix → test):Agent 修 bug 最大的风险是"从报告直接跳到补丁"——没验证诊断,也没确认补丁真能消除症状。bug 扩展把每次修复锁定在证据链上:先评估根因,再修评估出的原因,最后测试修复是否真的解决了原始症状。全程用 slug 串联留档。
想法评估(intake → research → define → shape → decide):好点子在投入前先要证据。五步走完,产出明确的 go / needs-clarification / kill 决策文档。它刻意设计成独立流程——不建项目也能用;决定 go 了,再交接给 /speckit.specify。
这两个扩展说明 Spec Kit 的野心不止"写代码前写文档":规格化思维被应用到了修复和决策这两种同样容易失控的场景。
五、跨端边界
- Agent 支持:30+ 编码代理,CLI 和 IDE 型都覆盖,
specify integration list查看已装版本支持的列表 - 命令形态自适应:多数 Agent 用
/speckit.*斜杠命令;Codex CLI 和 skills 模式用$speckit-*;GitHub Copilot CLI 通过/agents选择;支持 skills 模式的可改装成 Agent Skill - 无人值守环境:CI 和 Agent harness 没有 PTY,
--non-interactive保证 init 不挂在交互选择器上 - 文档与代码分离:GitHub Pages 放文档和社区目录,仓库管代码
六、数据与状态流
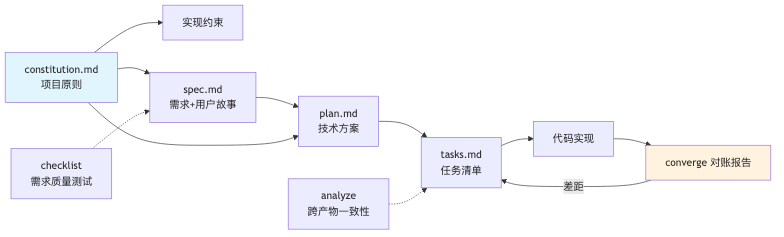
所有产物落在项目里(.specify/ 和 Agent 目录),纯文件、进 Git、可评审。没有服务端、没有数据库、没有锁定——换 Agent 的话,产物还在,流程照跑。这是"any AI coding agent"承诺的根基:状态在你手里。
七、配置边界
配置面三层,边界清晰:
- 装什么:
specify init --integration <agent>选目标代理;extension add/preset add装扩展和预设 - 怎么改:改流程用 Presets,加能力用 Extensions,单项目临时改用 overrides
- 自管理:
specify self check/upgrade管 CLI 升级,支持固定 tag、dry-run 预览、超时控制
要求只有一个:装 uv(也发 PyPI)。除此之外零依赖。
八、扩展点
这是 Spec Kit 最像"平台"的部分:
- Extensions:加新命令新模板,官方示例有 Jira 集成、实现后代码评审、V 模型测试追溯、项目健康诊断
- Presets:改现有工作流,可以激进到把整个流程本地化成另一种语言,甚至有个 pirate-speak 演示——让 spec 全用海盗黑话写
- Bundles:把扩展和预设组合成角色套装
- 社区目录:扩展、预设、Bundles、端到端 Walkthroughs、周边项目(Friends)都有独立页面,带独立发布指南
官方很诚实:社区贡献独立维护,装之前自己审代码。
九、风险点
1. 流程成本是真的。六个命令走完才动手写代码,对原型验证、小工具是杀鸡用牛刀。SDD 适合"建错代价高"的场景,一次性的 quick hack 别硬套。
2. 规格写不好,一切白搭。garbage in, garbage out 在这里格外刺眼——Agent 会忠实实现你模糊的规格,converge 循环对齐的也是那份烂规格。checklist 能帮一半,另一半还是靠写需求的人。
3. 模板栈有复杂度税。四层优先级 + 多预设叠加 + 运行时解析,团队里的人都得理解这套规则,否则"为什么这个模板生效了"会变成悬案。中小团队建议只用 core + 一个 preset。
4. Agent 兼容性长尾。30+ 代理号称都支持,但命令形态、skills 模式支持程度不一,边缘代理的体验需要自己验证。
5. 规格不是契约。converged 只代表实现和文档对齐,不代表产品正确——需求本身的错误,流程救不了。
记住
AI 编程时代,生成代码是最便宜的一步,写清楚"要建什么"成了最贵的一步。
Spec Kit 把规格变成可执行的源头产物:Specify → Plan → Tasks → Implement → Converge,对齐了才算完。
"给英语写单元测试"——需求质量第一次有了可操作的检验手段。
参考资源
- GitHub:https://github.com/github/spec-kit
- 文档:https://github.github.io/spec-kit
- 安装:
uv tool install specify-cli - License:MIT