
Hugging Face Speech-to-Speech:本地语音代理全栈
前言:当语音代理成为本地应用
想象这样一个场景:
你想构建一个语音助手——可以对话、可以控制、可以理解。但问题来了:
传统方案的痛点:
- 需要云端 API,依赖网络连接
- 延迟高,用户体验差
- 数据隐私问题,语音需要上传云端
- 成本高,每次调用都需要付费
- 无法定制,受限于云端服务商的能力
如果有一个全本地、全开源的语音代理解决方案呢?
Hugging Face Speech-to-Speech 正是这样的解决方案:一个低延迟、完全模块化的语音代理流水线,VAD → STT → LLM → TTS,通过 OpenAI Realtime 兼容的 WebSocket API 暴露。每个组件都可替换。
今天,我们就来深入分析这个革命性的开源项目。
一、项目概览
1.1 是什么?
Speech-to-Speech 是 Hugging Face 推出的开源语音代理框架。
核心特点:
- ✅ 低延迟:实时语音对话,延迟极低
- ✅ 完全模块化:VAD → STT → LLM → TTS,每个组件都可替换
- ✅ OpenAI Realtime 兼容:支持标准语音 API
- ✅ 全本地部署:可完全在本地运行,无需云端
- ✅ 全开源:Apache-2.0 协议,完全开源
- ✅ 生产验证:已用于数千台 Reachy Mini 机器人的对话后端
- ✅ 多语言支持:支持多种 STT 和 TTS 模型
- ✅ 灵活部署:支持本地、WebSocket、TCP Socket 多种模式
项目地址:https://github.com/huggingface/speech-to-speech PyPI:https://pypi.org/project/speech-to-speech/ 开源协议:Apache-2.0 License
1.2 核心价值
传统云端语音助手的痛点:
- 需要云端 API,依赖网络连接
- 延迟高,用户体验差
- 数据隐私问题,语音需要上传云端
- 成本高,每次调用都需要付费
- 无法定制,受限于云端服务商的能力
Speech-to-Speech 的解决方案:
- 全本地部署,无需云端
- 低延迟,实时语音对话
- 数据隐私,语音不离开设备
- 零成本,本地运行免费
- 完全定制,每个组件都可替换
二、核心架构
2.1 四阶段流水线
核心思想: 语音代理的流水线是一个级联的四个组件,每个组件在自己的线程中运行,通过队列连接:
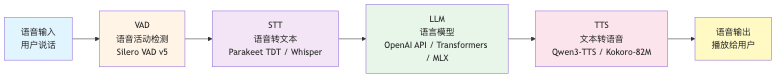
1. Voice Activity Detection (VAD)
- Silero VAD v5:检测语音边界和轮次切换
- 核心功能:判断用户何时开始说话、何时停止说话
- 支持实时处理,延迟极低
2. Speech to Text (STT)
- Parakeet TDT(默认):本地 STT,支持 CUDA / CPU / Apple Silicon
- Whisper:通过 Transformers,支持 CUDA / CPU
- Faster Whisper:更快的 Whisper 实现
- Lightning Whisper MLX:Apple Silicon 上的闪电般快速的 Whisper
- MLX Audio Whisper:Apple Silicon 上的 MLX Audio 实现
- Paraformer:通过 FunASR,支持 CUDA / CPU
3. Language Model (LLM)
- OpenAI-compatible API:支持 OpenAI Responses API、Chat Completions API
- Transformers:通过 Hugging Face Transformers,支持 CUDA / CPU
- mlx-lm:Apple Silicon 上的 MLX LM 实现
- 本地服务器:支持 vLLM、llama.cpp 等本地服务器
4. Text to Speech (TTS)
- Qwen3-TTS(默认):支持 GGML / CUDA / MLX Audio
- Kokoro-82M:轻量级 TTS,支持 CPU / CUDA / Apple Silicon
- Pocket TTS:CPU / CUDA 支持
- ChatTTS:对话式 TTS
- MMS TTS:通过 Transformers,支持多语言
2.2 模块化设计
核心思想: 每个阶段都有多个可互换的后端,通过 CLI 标志选择。
优势:
- 完全定制:根据需求选择每个组件
- 易于扩展:添加新的后端非常简单
- 平台适配:自动选择最佳实现(如 macOS 使用 MLX)
- 生产验证:已用于数千台 Reachy Mini 机器人
示例:
# 使用 Faster Whisper + Transformers LLM + Kokoro TTS
speech-to-speech \
  --stt faster-whisper \
  --llm_backend transformers \
  --tts kokoro

# 使用本地 llama.cpp 服务器
speech-to-speech \"
  --model_name "ggml-org/gemma-4-E4B-it-GGUF" \
  --responses_api_base_url "http://127.0.0.1:8080/v1" \
  --responses_api_api_key ""
三、安装与使用
3.1 快速开始
安装:
pip install speech-to-speech启动服务器:
export OPENAI_API_KEY=...
speech-to-speech
这会启动一个 OpenAI Realtime 兼容的服务器,地址为 ws://localhost:8765/v1/realtime,使用:
- Parakeet TDT:本地 STT
- OpenAI-compatible API:LLM
- Qwen3-TTS:本地语音输出
从源码测试:
python scripts/listen_and_play_realtime.py --host 127.0.0.1 --port 87653.2 本地 LLM 部署
使用 llama.cpp 运行 Gemma 4:
llama-server -hf ggml-org/gemma-4-E4B-it-GGUF -np 2 -c 65536 -fa on --swa-full指向本地 LLM:
speech-to-speech \
  --model_name "ggml-org/gemma-4-E4B-it-GGUF" \
  --responses_api_base_url "http://127.0.0.1:8080/v1" \
  --responses_api_api_key ""
3.3 可选后端
安装额外的后端:
pip install "speech-to-speech[kokoro]"        # Kokoro-82M TTS
pip install "speech-to-speech[pocket]"        # Pocket TTS
pip install "speech-to-speech[chattts]"      # ChatTTS
pip install "speech-to-speech[facebook-mms]"  # MMS TTS
pip install "speech-to-speech[faster-whisper]"  # Faster Whisper STT
pip install "speech-to-speech[whisper-mlx]"   # Lightning Whisper MLX STT on macOS
pip install "speech-to-speech[paraformer]"    # Paraformer STT
pip install "speech-to-speech[mlx-lm]"        # mlx-vlm support for vision models on macOS
3.4 CUDA 注意事项
Qwen3-TTS GGML 后端:
- 在 Linux 上,默认的 qwentts-cpp-python wheel 目标是 CUDA 12.8
- 如果你的机器没有 CUDA 12 运行时,需要从 Hugging Face wheelhouse 安装匹配的 wheel:
# CUDA 13.x
pip install "qwentts-cpp-python==0.3.1+cu130" \
  -f https://huggingface.co/datasets/andito/qwentts-cpp-python-wheels/tree/main/whl/cu130

# CUDA 12.4
pip install "qwentts-cpp-python==0.3.1+cu124" \
  -f https://huggingface.co/datasets/andito/qwentts-cpp-python-wheels/tree/main/whl/cu124

# CPU-only fallback
pip install "qwentts-cpp-python==0.3.1+cpu" \
  -f https://huggingface.co/datasets/andito/qwentts-cpp-python-wheels/tree/main/whl/cpu

pip install speech-to-speech
四、运行模式
4.1 四种运行模式
| 模式 | 传输方式 | 使用场景 |
|---|---|---|
| realtime(默认) | WebSocket,OpenAI Realtime 协议 | 你正在构建一个应用或设备,基于标准语音 API |
| local | 本地麦克风和扬声器 | 你想直接与流水线对话,无需客户端 |
| websocket | WebSocket 上的原始 PCM | 你想要一个最小的自定义客户端,无需 Realtime 协议 |
| socket | TCP Socket 上的原始 PCM | 模型在远程服务器上运行,使用简单的麦克风/播放客户端 |
4.2 Realtime Server
启动:
export OPENAI_API_KEY=...
speech-to-speech等价于:
speech-to-speech \
  --thresh 0.6 \
  --stt parakeet-tdt \
  --llm_backend responses-api \
  --tts qwen3 \
  --qwen3_tts_model_name Qwen/Qwen3-TTS-12Hz-1.7B-CustomVoice \
  --qwen3_tts_speaker Aiden \
  --qwen3_tts_language auto \
  --qwen3_tts_backend ggml \
  --qwen3_tts_non_streaming_mode True \
  --qwen3_tts_mlx_quantization 6bit \
  --model_name gpt-5.4-mini \
  --chat_size 30 \
  --responses_api_stream \
  --enable_live_transcription \
--mode realtime特点:
- 默认模型是 gpt-5.4-mini(通过 OpenAI Responses API)
- 可通过
--model_name覆盖 - 可通过
--responses_api_base_url指向其他 OpenAI 兼容的提供商或服务器
4.3 Local Mac
启动:
speech-to-speech --local_mac_optimal_settings指定 LLM:
speech-to-speech \
  --local_mac_optimal_settings \
  --model_name mlx-community/Qwen3-4B-Instruct-2507-bf16
--local_mac_optimal_settings 设置:
- 添加
--device mps:所有模型使用 MPS - 设置 Parakeet TDT:STT
- 设置 MLX LM:LLM 后端
- 设置 Qwen3-TTS:TTS,使用 mlx-audio,默认使用 6bit MLX 变体
- 设置
--mode local
其他 macOS 选项:
--tts pocket:Pocket TTS--tts kokoro:Kokoro-82M
比较 MLX 量化变体:
python scripts/benchmark_tts.py \
  --handlers qwen3 \
  --iterations 3 \
  --qwen3_mlx_quantizations bf16 4bit 6bit 8bit
4.4 WebSocket
启动:
speech-to-speech --mode websocket --ws_host 0.0.0.0 --ws_port 8765连接:
- 在
ws://:8765连接 - 发送原始音频字节:16 kHz,int16,mono PCM
- 接收生成的音频字节
4.5 TCP Socket
特点:
- TCP socket 模式故意最小化
- 流式传输原始 PCM 音频
- 不提供完整的 Realtime API 功能集,包括中断处理、实时转录事件或工具调用事件
服务器端:
speech-to-speech --mode socket --recv_host 0.0.0.0 --send_host 0.0.0.0客户端:
python scripts/listen_and_play.py --host4.6 Docker
安装 NVIDIA Container Toolkit:
docker compose upCompose 文件启动:
- llama.cpp 服务器,运行 Gemma 4
- TCP socket 服务器
- 暴露端口 8080、12345、12346
五、支持的组件
5.1 VAD(语音活动检测)
| 后端 | 平台 | 安装 |
|---|---|---|
| Silero VAD v5 | all | built-in |
5.2 STT(语音转文本)
| 后端 | 平台 | 安装 |
|---|---|---|
| Parakeet TDT(默认) | CUDA / CPU(通过 nano-parakeet),Apple Silicon(通过 MLX) | built-in |
| Whisper | CUDA / CPU(通过 Transformers) | built-in |
| Faster Whisper | CUDA / CPU | faster-whisper |
| Lightning Whisper MLX | Apple Silicon | whisper-mlx |
| MLX Audio Whisper | Apple Silicon | macOS built-in |
| Paraformer | CUDA / CPU(通过 FunASR) | paraformer |
5.3 LLM(语言模型)
| 后端 | 平台 | 安装 |
|---|---|---|
| OpenAI-compatible API | 托管提供商或自托管服务器 | built-in |
| Transformers | CUDA / CPU | built-in |
| mlx-lm | Apple Silicon | macOS built-in |
5.4 TTS(文本转语音)
| 后端 | 平台 | 安装 |
|---|---|---|
| Qwen3-TTS(默认) | GGML / CUDA(Linux),mlx-audio(macOS) | built-in |
| Kokoro-82M | CUDA / CPU,Apple Silicon | kokoro(非 macOS),macOS built-in |
| Pocket TTS | CPU / CUDA | |
| ChatTTS | CUDA / CPU | chattts |
| MMS TTS | CUDA / CPU(通过 Transformers) | facebook-mms |
选择后端:
- 使用
--stt、--llm_backend、--tts选择 - 运行
speech-to-speech -h查看精确值和后端特定标志
六、Realtime API
6.1 OpenAI Realtime 兼容
核心能力:
- Realtime 模式使用 OpenAI Realtime 协议通过 WebSocket 流式传输音频
- 支持实时转录
- 低延迟轮次切换
- 服务器暴露
/v1/realtime - 任何 OpenAI Realtime 兼容的客户端都可以连接
特点:
- 标准 API:兼容 OpenAI Realtime API
- 实时转录:支持实时转录事件
- 低延迟:优化的轮次切换
- 工具调用:支持工具调用事件
- 中断处理:支持用户中断
6.2 协议特性
支持的事件:
- 音频流事件
- 实时转录事件
- 工具调用事件
- 中断处理事件
- 错误事件
优势:
- 标准化:使用 OpenAI 标准
- 兼容性:任何 OpenAI Realtime 客户端都可以连接
- 灵活性:支持多种使用场景
七、LLM 后端
7.1 托管提供商
OpenAI:
speech-to-speech \
  --model_name gpt-5.4-mini \
  --responses_api_base_url https://api.openai.com/v1 \
  --responses_api_api_key $OPENAI_API_KEY
其他 OpenAI 兼容提供商:
speech-to-speech \
  --model_name llama-3.1-70b-instruct \
  --responses_api_base_url https://api.deepbricks.ai/v1 \
  --responses_api_api_key $DEEPBRICKS_API_KEY
7.2 本地服务器
llama.cpp:
# 启动 llama.cpp 服务器
llama-server -hf ggml-org/gemma-4-E4B-it-GGUF -np 2 -c 65536 -fa on --swa-full

# 指向本地服务器
speech-to-speech \
  --model_name "ggml-org/gemma-4-E4B-it-GGUF" \
  --responses_api_base_url "http://127.0.0.1:8080/v1" \
--responses_api_api_key ""vLLM:
# 启动 vLLM 服务器
python -m vllm.entrypoints.openai.api_server \
  --model meta-llama/Llama-3.1-70B-Instruct \
  --host 0.0.0.0 \
  --port 8000

# 指向 vLLM 服务器
speech-to-speech \
  --model_name "meta-llama/Llama-3.1-70B-Instruct" \
  --responses_api_base_url "http://127.0.0.1:8000/v1" \
  --responses_api_api_key ""
7.3 本地模型
Transformers:
speech-to-speech \
  --llm_backend transformers \
--model_name mlx-community/Qwen3-4B-Instruct-2507-bf16mlx-lm(macOS):
speech-to-speech \
  --llm_backend mlx-lm \
  --model_name mlx-community/Qwen3-4B-Instruct-2507-bf16
八、多语言支持
8.1 STT 多语言
支持的语言:
- Parakeet TDT:英语
- Whisper:多语言(支持 99 种语言)
- Faster Whisper:多语言
- Lightning Whisper MLX:多语言
- MLX Audio Whisper:多语言
- Paraformer:中文
选择:
# 英语
speech-to-speech --stt parakeet-tdt

# 多语言
speech-to-speech --stt whisper

# 中文
speech-to-speech --stt paraformer
8.2 TTS 多语言
支持的语言:
- Qwen3-TTS:多语言(英语、中文、日语、韩语等)
- Kokoro-82M:英语、日语
- Pocket TTS:英语、法语
- ChatTTS:中文、英语
- MMS TTS:多语言(支持 1000+ 种语言)
选择:
# 多语言
speech-to-speech --tts qwen3 --qwen3_tts_language auto

# 英语
speech-to-speech --tts kokoro

# 中文
speech-to-speech --tts chattts

# 多语言(1000+ 种语言)
speech-to-speech --tts facebook-mms
九、Pocket TTS
9.1 什么是 Pocket TTS?
Pocket TTS 是由 Kyutai Labs 开发的轻量级 TTS 模型,特点:
- 轻量级:模型小,推理快
- 高质量:语音质量高
- 多语言:支持英语、法语等
- 灵活:支持 CPU / CUDA
9.2 使用 Pocket TTS
安装:
pip install "speech-to-speech[pocket]"使用:
speech-to-speech --tts pocket特点:
- 适合资源受限的设备
- 推理速度快
- 语音质量高
十、实际应用场景
10.1 智能家居
场景:
- 语音控制家电
- 语音查询天气
- 语音播放音乐
- 语音设置闹钟
使用 Speech-to-Speech:
speech-to-speech \
  --local_mac_optimal_settings \
--model_name mlx-community/Qwen3-4B-Instruct-2507-bf16优势:
- 全本地运行,无需云端
- 低延迟,实时响应
- 数据隐私,语音不离开设备
10.2 车载语音助手
场景:
- 语音导航
- 语音播放音乐
- 语音拨打电话
- 语音查询信息
使用 Speech-to-Speech:
speech-to-speech \
  --mode realtime \
  --stt faster-whisper \
  --llm_backend responses-api \
--tts kokoro优势:
- 低延迟,实时对话
- 高质量,语音清晰
- 可定制,根据需求选择组件
10.3 客户服务机器人
场景:
- 语音客服
- 语音问答
- 语音引导
- 语音反馈
使用 Speech-to-Speech:
speech-to-speech \
  --mode realtime \
  --stt whisper \
  --llm_backend transformers \
--tts qwen3优势:
- 实时转录,实时响应
- 多语言,支持多种语言
- 可定制,根据需求调整
10.4 教育应用
场景:
- 语音教学
- 语音练习
- 语音评测
- 语音反馈
使用 Speech-to-Speech:
speech-to-speech \
  --mode local \
  --stt paraformer \
  --llm_backend mlx-lm \
--tts chattts优势:
- 本地运行,无需云端
- 低延迟,实时反馈
- 多语言,支持多种语言
10.5 无障碍应用
场景:
- 语音辅助
- 语音朗读
- 语音输入
- 语音导航
使用 Speech-to-Speech:
speech-to-speech \
  --mode local \
  --stt whisper \
  --llm_backend transformers \
--tts qwen3优势:
- 本地运行,保护隐私
- 低延迟,实时响应
- 多语言,支持多种语言
十一、优势与局限
11.1 优势
1. 低延迟
- 实时语音对话,延迟极低
- 每个组件在自己的线程中运行
- 通过队列连接,高效传输
2. 完全模块化
- 每个组件都可替换
- 根据需求选择最佳实现
- 易于扩展和定制
3. OpenAI Realtime 兼容
- 支持标准语音 API
- 任何 OpenAI Realtime 客户端都可以连接
- 易于集成
4. 全本地部署
- 可完全在本地运行
- 无需云端,保护隐私
- 零成本,本地运行免费
5. 全开源
- Apache-2.0 协议
- 完全开源,可定制
- 社区活跃
6. 生产验证
- 已用于数千台 Reachy Mini 机器人
- 稳定可靠
- 经过实战检验
7. 多语言支持
- 支持多种 STT 和 TTS 模型
- 支持多种语言
- 灵活选择
8. 灵活部署
- 支持本地、WebSocket、TCP Socket 多种模式
- 支持多种平台(Linux、macOS、Windows)
- 支持多种硬件(CPU、CUDA、Apple Silicon)
11.2 局限
1. 硬件要求
- 需要 GPU 才能获得最佳性能
- CPU 模式性能较差
- Apple Silicon 需要特定优化
2. 模型大小
- STT 和 TTS 模型较大
- 需要足够的存储空间
- 加载时间较长
3. 配置复杂
- 需要配置多个组件
- 需要选择合适的后端
- 需要调整参数
4. 文档不够完善
- 部分功能文档不够详细
- 需要自行探索
- 社区支持有限
十二、最佳实践
12.1 选择合适的组件
STT 选择:
- 英语:Parakeet TDT(最快)
- 多语言:Whisper(最全)
- 中文:Paraformer(最佳)
- Apple Silicon:Lightning Whisper MLX(最快)
LLM 选择:
- 云端:OpenAI API(最简单)
- 本地 x86:llama.cpp(最快)
- 本地 Apple Silicon:mlx-lm(最佳)
TTS 选择:
- 多语言:Qwen3-TTS(最全)
- 英语:Kokoro-82M(最快)
- 中文:ChatTTS(最佳)
- 资源受限:Pocket TTS(最轻)
12.2 优化性能
使用 GPU:
- CUDA:最佳性能
- MPS(Apple Silicon):良好性能
- CPU:性能较差
量化模型:
- 使用量化后的模型
- 减少内存占用
- 提高推理速度
多线程:
- 每个组件在自己的线程中运行
- 通过队列连接
- 充分利用多核 CPU
12.3 优化延迟
使用快速组件:
- STT:Faster Whisper、Lightning Whisper MLX
- LLM:本地服务器(llama.cpp、vLLM)
- TTS:Kokoro-82M、Pocket TTS
减少队列大小:
- 调整队列大小
- 减少缓冲
- 降低延迟
优化参数:
- 调整 VAD 阈值
- 调整 STT 和 TTS 参数
- 调整 LLM 参数
十三、未来展望
13.1 短期未来
功能增强:
- 更多 STT 和 TTS 模型
- 更多 LLM 后端
- 更多运行模式
性能优化:
- 更低的延迟
- 更高的质量
- 更少的资源占用
13.2 中期未来
能力扩展:
- 视觉能力(mlx-vlm)
- 多模态能力
- 更强的上下文理解
生态建设:
- 更多客户端
- 更多集成
- 更多教程
13.3 长期未来
智能化:
- 自动优化组件选择
- 自动调整参数
- 自动学习用户偏好
标准化:
- 建立语音代理标准
- 建立最佳实践
- 建立社区
十四、总结
14.1 核心回顾
Speech-to-Speech:
- ✅ 低延迟、完全模块化的语音代理流水线
- ✅ VAD → STT → LLM → TTS,每个组件都可替换
- ✅ OpenAI Realtime 兼容的 WebSocket API
- ✅ 全本地部署,无需云端
- ✅ 全开源,Apache-2.0 协议
- ✅ 生产验证,已用于数千台 Reachy Mini 机器人
- ✅ 多语言支持,支持多种 STT 和 TTS 模型
- ✅ 灵活部署,支持多种模式和平台
核心价值:
- 低延迟:实时语音对话
- 完全模块化:每个组件都可替换
- 全本地部署:保护隐私,零成本
- 全开源:可定制,社区活跃
14.2 关键要点
"从云端到本地"
传统方案需要云端 API,Speech-to-Speech 可以完全在本地运行。
"从固定到模块化"
传统方案组件固定,Speech-to-Speech 每个组件都可替换。
"从封闭到开放"
传统方案受限于云端服务商,Speech-to-Speech 完全开源,可定制。
"从单一到多语言"
传统方案支持有限的语言,Speech-to-Speech 支持多种语言。
"Speech-to-Speech 的本质"
"Speech-to-Speech 不是要替代云端语音助手,而是要让语音代理成为本地应用,保护隐私,零成本,完全定制。"
核心价值:
- 低延迟:实时语音对话
- 完全模块化:每个组件都可替换
- 全本地部署:保护隐私,零成本
- 全开源:可定制,社区活跃
- 多语言支持:支持多种语言
- 灵活部署:支持多种模式和平台
- 生产验证:稳定可靠
这就是 Speech-to-Speech 的野心:让语音代理成为本地应用,保护隐私,零成本,完全定制。
参考资源
- GitHub 项目:https://github.com/huggingface/speech-to-speech
- PyPI:https://pypi.org/project/speech-to-speech/
- Hugging Face Hub:https://huggingface.co/
- Reachy Mini:https://huggingface.co/blog/reachy-mini
如果你觉得这篇文章有帮助,欢迎点赞、转发,让更多人了解这个构建本地语音代理的开源全栈!