
Why Software Factories Fail:为什么软件工厂会失败
前言:当软件工厂遇上 AI
想象这样一个场景:
你正在构建一个软件工厂,代码由 AI 自动生成,测试由 AI 自动运行,审查由 AI 自动完成,部署由 AI 自动触发。人类只需要输入需求,然后等待软件自动构建。 " 这就是"灯光熄灭"的软件工厂愿景。
但现实是什么?
- 代码质量下降
- 事故率上升
- Bug 数量激增
- 代码库变得难以维护
为什么软件工厂会失败?
今天,我们就来深入分析 Dex Hunter(HumanLayer 创始人)的文章《Why Software Factories Fail》,探讨软件工厂的困境与出路。
一、软件工厂的兴起
1.1 什么是软件工厂?
软件工厂是一个自动化的软件开发流水线,包括:
- 需求管理
- 代码生成
- 自动测试
- 自动审查
- 自动部署
- 监控反馈
核心思想:
- 代码是免费的
- 模型足够好
- 你是瓶颈
- 只需要交付更多
1.2 软件工厂的历史
软件工厂的概念可以追溯到 1968 年:
- NATO 会议首次提出"软件工程"概念
- 同时也提出了"软件工厂"的愿景
2022 年的软件工厂(AI 之前):
- 人们决定构建什么
- 放入追踪系统(Linear、Jira)
- 有人领取工单并构建
- Pull Request:自动检查 + 人工审查
- 如果有问题,循环回到"有人构建"
- 部署到生产环境
- 添加监控
- 用户反馈 → 回到团队
AI 时代的软件工厂:
- Ramp:75% 的代码由 Agent 生成
- Stripe:Minions 一键式端到端编码 Agent
- WorkOS:Project Horizon
- Brex:AI 驱动的开发
1.3 Loop Engineering
Loop Engineering(循环工程)是当前的主流思想:
- 编写更多循环
- 自动化更多流程
- 减少人工干预
Ryan Lopopolo(OpenAI):
- 2026 年 2 月:撰写关于 Harness Engineering 的文章
- 2026 年 4 月:发表关于 OpenAI 软件工厂 Symphony 的演讲
StrongDM:
- 灯光熄灭的软件工厂
- 没有人读取代码
- 没有人编写代码
二、软件工厂的现实
2.1 Faros AI 报告
Faros AI 的研究报告显示:
- 自 2026 年 1-2 月,大家开始使用 AI 编码工具
- Pull Request 审查质量大幅下降:
- 更多审查评论(+25%)
- 更长的评论(+22.7%)
- 大量 PR 跳过审查(+31.3%)
- 事故率大幅上升:
- 每个 PR 的事故(+242.7%)
- 月度事故(+57.9%)
- 每个 Bug 的 Bug 数量大幅上升(+54%)
2.2 Matt Pocock 的观察
Matt Pocock 指出:
- 代码库崩溃的速度比以往任何时候都快
- 代码质量下降的速度前所未有
2.3 Mario 的警告
Mario(badlogicgames)在 AI Engineer Europe 上恳求:
- 请慢下来
- 那些不应该因为编码 Agent 事故而中断的公司,正在因为编码 Agent 事故而中断
三、软件工厂的演进
3.1 2022 年软件工厂
核心流程: 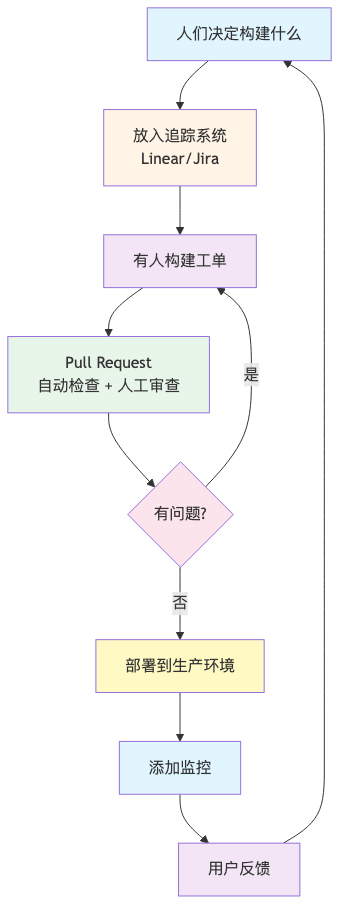
3.2 前置对齐
团队几十年前就发现:
- 构建需要数小时或数天
- 审查也需要数小时或数天
解决方案:前置对齐
- 规划
- 架构提案
- Sprint 规划
优势:
- 更少的返工(在编写代码之前就对齐)
- 更快的审查(如果 PR 做得很好,审查会很快)
3.3 Agent 软件工厂
核心流程: 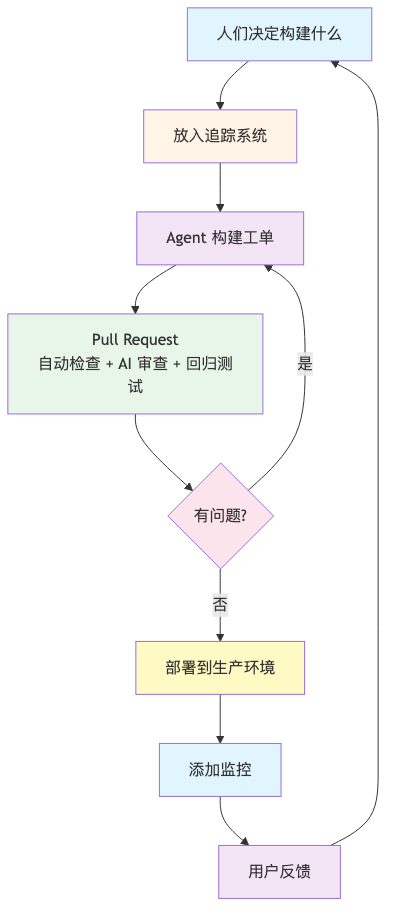
变化:
- 构建时间:从数小时/数天 → 数分钟/数小时
- 审查时间:仍然是数小时/数天(成为瓶颈)
加速审查:
- Agent 代码审查:捕获样式、Bug、安全问题
- Agent 回归测试:从外部测试,发送视频反馈
路由更多循环:
- 事故路由到工厂:3 点不再呼叫,而是醒来看到一个 PR
- 用户反馈路由到工厂:人们要求功能,自动构建
3.4 灯光熄灭的软件工厂
Dan Shapiro 创造了这个术语,Simon Willison 撰写了 StrongDM 的实现。
核心思想:不再读取代码。
流程: 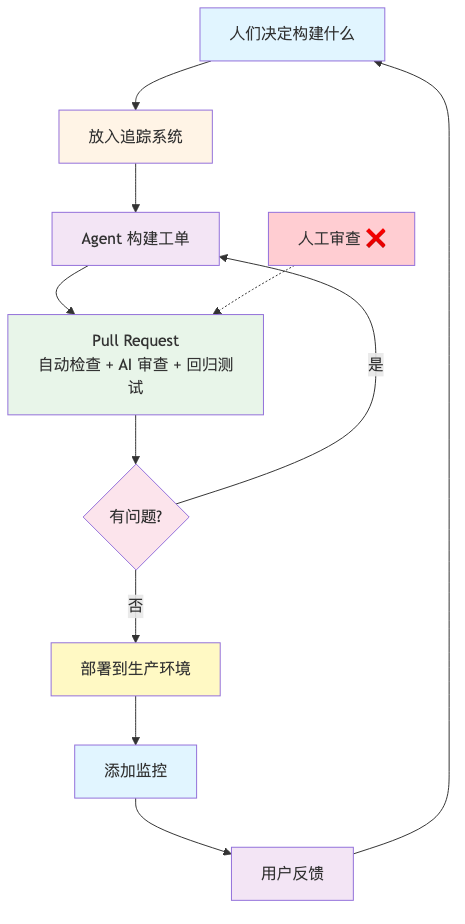
投资方向:
- 测试和 Agent 自我测试
- 沙箱和编排
- 自动审查
- 监控
- 部署
- 用户反馈信号收集
问题:如何向队列中添加更多内容?
四、为什么软件工厂会失败
4.1 作者的亲身经历
2025 年 7 月:作者尝试完全灯光熄灭:
- 只读取规格和工单
- 所有小型/中型任务都使用后台 Agent
- 全部自动化
结果:
- 找到至少一个 Agent 无法解决的问题
- 即使使用最先进的提示和工作流
- 最终不得不深入代码库
- 代码库在三个月前停止阅读
后果:
- 网站宕机
- 用户愤怒
- 阅读所有让代码库变得混乱的 slop 代码
- 非常痛苦
第一次:虽然很痛苦,但"速度值得风险"。
第三次(11 月):决定从头开始重写,联合创始人在 VS Code 中花费了两周时间手动整理所有模式。
4.2 模型随时间降低代码库质量
核心问题:
- 模型无法随时间维持和改进代码库质量
- 至少没有相当数量的人工指导
可维护性:
- Martin Fowler 的"霰弹枪手术"(Shotgun Surgery)
- 很难在不破坏另一部分的情况下更改代码库的一部分
为什么模型不能做到软件可维护性?
- 没有好的基准测试
- 模型倾向于让事情变得更糟
- 让代码库更难工作
4.3 模型变好了吗?
2025-2026 年的变化:
- 解决一次性问题:是的,好多了
- 改进代码库质量:差不多
问题:
- 无法证明这一点
- 没有好的基准测试
结论:
没有好的基准测试来衡量模型维持代码库质量的能力
4.4 Claude Code 的成功
Claude Code 的收入:
- 从零到 ~$4B(不到一年)
- 现在大约 ~$9B
为什么 Claude Code 成功了?
在 Harness 中的强化学习(RLVR):
- 不是更好的工具
- 不是更好的上下文工程
- 而是在 Harness 中的强化学习
其他 Agent:
- aider、cline、codebuff
- 都在 Claude Code 之前
- 都有真正好的上下文工程
- 都有相同的工具集:read、write、edit、grep、bash
- 工具使用会失败
SWE-Agent 论文:
- 证明了在 Harness 中的强化学习的有效性
- Agent 可以从自己的错误中学习
- Agent 可以改进自己的工作流程
五、核心观点
5.1 这不是技能问题
核心观点:
没有多少 Harness Engineering 或 Loopmaxxing 可以解决根本上的模型训练问题
常见的错误建议:
- "你只是在错误地使用它"
- "你只需要花更多 Token"
- "停止阅读代码"
这些都是技能问题的指责,但实际上:
- 这是一个模型训练问题
- 不是技能问题
- 不是上下文工程问题
5.2 Vibe Coding vs. 生产软件
Addy Osmani 的观点:
一个开发者 Vibe coding 一个只有十几个人会运行的副业项目,和一个团队保持一个十年企业系统再活一个季度,几乎没有共同的约束值得命名
Vibe Coding:
- 适合副业项目
- 适合原型
- 适合小规模应用
生产软件:
- 需要长期维护
- 需要团队协作
- 需要质量保证
Brownfield:
- 历史上意味着十年前的 Java 东西
- 现在意味着 Agent 构建的代码库在 3-6 个月后开始挣扎
- 你开始减速
- 你添加新东西的方式必须改变
5.3 前置对齐的重要性
2022 年的教训:
- 构建需要数小时或数天
- 审查也需要数小时或数天
解决方案:前置对齐
- 规划
- 架构提案
- Sprint 规划
优势:
- 更少的返工
- 更快的审查
AI 时代的教训:
- 构建需要数分钟或数小时
- 审查仍然需要数小时或数天
解决方案:
- 不要放弃人工审查
- 前置对齐仍然重要
- 质量 > 速度
六、如何在不破坏代码库的情况下快速移动
6.1 平衡速度和质量
核心思想:
- 不要追求 10x-100x 速度
- 追求 2x-3x 速度 + 高质量
实践:
- 保持人工审查
- 前置对齐
- 测试驱动开发
- 持续重构
6.2 使用 Agent 的正确方式
不要:
- 完全灯光熄灭
- 不读取代码
- 不审查代码
要:
- 使用 Agent 加速构建
- 保持人工审查
- 使用 Agent 加速测试
- 使用 Agent 加速部署
6.3 上下文工程的重要性
核心思想:
- 上下文工程仍然重要
- 但不是银弹
- 需要与模型训练结合
实践:
- 提供足够的上下文
- 提供清晰的指令
- 提供良好的示例
- 提供反馈循环
6.4 模型训练的重要性
核心思想:
- 模型训练是关键
- 上下文工程不是银弹
- 需要 RLVR(Reinforcement Learning inside the harness)
实践:
- 使用强化学习
- 让 Agent 从错误中学习
- 让 Agent 改进工作流程
七、实际应用场景
7.1 小型项目
场景:
- 副业项目
- 原型
- 小型应用
建议:
- 可以使用 Vibe Coding
- 可以使用 Agent 生成代码
- 可以减少人工审查
原因:
- 影响范围小
- 可以快速迭代
- 质量要求不高
7.2 中型项目
场景:
- 内部工具
- 中型应用
- 团队项目
建议:
- 保持人工审查
- 前置对齐
- 测试驱动开发
原因:
- 影响范围中等
- 需要团队协作
- 质量要求中等
7.3 大型项目
场景:
- 企业系统
- 大型应用
- 生产系统
建议:
- 保持人工审查
- 前置对齐
- 测试驱动开发
- 持续重构
原因:
- 影响范围大
- 需要长期维护
- 质量要求高
八、最佳实践
8.1 不要追求灯光熄灭
核心原则:
- 不要完全放弃人工审查
- 不要完全停止读取代码
- 不要完全自动化
实践:
- 保持人工审查
- 保持代码阅读
- 保持质量保证
8.2 前置对齐
核心原则:
- 在编写代码之前对齐
- 减少返工
- 加快审查
实践:
- 规划
- 架构提案
- Sprint 规划
8.3 测试驱动开发
核心原则:
- 先写测试
- 再写代码
- 持续重构
实践:
- 单元测试
- 集成测试
- 端到端测试
8.4 持续重构
核心原则:
- 持续改进代码质量
- 避免技术债务积累
- 保持代码可维护性
实践:
- 定期重构
- 代码审查
- 技术债务管理
九、未来展望
9.1 模型训练的改进
短期未来:
- 更好的基准测试
- 更好的强化学习
- 更好的上下文理解
中期未来:
- 更好的代码质量维持
- 更好的可维护性
- 更好的长期维护
长期未来:
- 可能的灯光熄灭
- 但需要更好的模型
- 需要更好的基准测试
9.2 上下文工程的改进
短期未来:
- 更好的上下文提取
- 更好的上下文压缩
- 更好的上下文传递
中期未来:
- 更好的上下文管理
- 更好的上下文理解
- 更好的上下文应用
长期未来:
- 自动上下文工程
- 自适应上下文
- 智能上下文
9.3 软件工厂的演进
短期未来:
- 更好的工具
- 更好的工作流程
- 更好的集成
中期未来:
- 更好的自动化
- 更好的监控
- 更好的反馈
长期未来:
- 可能的灯光熄灭
- 但需要更好的模型
- 需要更好的基准测试
十、总结
10.1 核心回顾
软件工厂的兴起:
- 1968 年:NATO 会议首次提出
- 2022 年:AI 之前的软件工厂
- 2026 年:AI 时代的软件工厂
软件工厂的现实:
- Faros AI 报告:代码质量下降
- Matt Pocock:代码库崩溃速度加快
- Mario:请慢下来
为什么软件工厂会失败:
- 模型无法随时间维持和改进代码库质量
- 没有好的基准测试
- 倾向于让事情变得更糟
如何在不破坏代码库的情况下快速移动:
- 平衡速度和质量
- 使用 Agent 的正确方式
- 上下文工程的重要性
- 模型训练的重要性
10.2 关键要点
"从速度到质量"
传统软件工厂追求速度,AI 时代的软件工厂应该追求质量。
"从自动化到智能化"
传统软件工厂追求自动化,AI 时代的软件工厂应该追求智能化。
"从灯光熄灭到灯光调暗"
传统软件工厂追求灯光熄灭,AI 时代的软件工厂应该追求灯光调暗。
"Why Software Factories Fail 的本质"
"Why Software Factories Fail 不是要反对软件工厂,而是要反对过度自动化、过度追求速度、过度放弃人工审查。软件工厂应该平衡速度和质量,应该保持人工审查,应该前置对齐。"
核心价值:
- 平衡速度和质量
- 保持人工审查
- 前置对齐
- 测试驱动开发
- 持续重构
- 上下文工程
- 模型训练
这就是 Why Software Factories Fail 的核心:不要追求灯光熄灭,要追求灯光调暗;不要追求速度,要追求质量;不要放弃人工审查,要保持人工审查。
参考资源
- 文章:https://github.com/humanlayer/advanced-context-engineering-for-coding-agents/blob/main/wsff.md
- 视频:https://www.youtube.com/watch?v=Ib5GBkD555M(AI Engineer World's Fair 2026)
- Faros AI 报告:https://www.faros.ai/research/ai-acceleration-whiplash
- StrongDM 软件工厂:https://factory.strongdm.ai
- OpenAI Harness Engineering:https://openai.com/index/harness-engineering/
如果你觉得这篇文章有帮助,欢迎点赞、转发,让更多人了解软件工厂的困境与出路!